DGX Spark GB10 로컬 LLM 벤치마크
현재 상태. Standard Benchmark 기준 현재 23개 model variant와 7개 suite를 공개하고 있다. 최신 public release는 2026년 9월 10일 기준이며, 최신 숫자와 비교 matrix의 source of truth는 DGX Spark GB10 — Local LLM Benchmark다.
이 페이지는 DGX Spark GB10에서 직접 측정한 로컬 LLM 결과와 테스트 과정, 성능 변화, 에이전트 평가를 계속 누적하는 living benchmark report다.
This is a living benchmark report. Results and conclusions are updated as new models and runtime optimizations are tested.
로컬에서 실행할 수 있는 LLM이 빠르게 늘고 있다.
같은 모델도 Q4, Q5, Q6, Q8, NVFP4, MXFP4, UD quant처럼 여러 형태로 배포되고, MTP 지원 여부나 튜닝 방식에 따라 실제 사용감도 크게 달라진다.
모델 카드에는 다양한 공개 벤치마크 결과가 있지만, 내가 궁금했던 것은 조금 더 단순했다.
내 NVIDIA DGX Spark GB10에서 실제로 돌렸을 때 어떤 모델이 빠르고, 어떤 모델이 코드를 잘 만들며, 어떤 모델이 도구를 잘 사용하고 여러 단계의 작업을 끝까지 수행하는가?
그래서 직접 로컬 LLM 벤치마크 시스템을 만들고, 현재 가지고 있는 GGUF 모델들을 같은 조건에서 비교했다.
첫 공개 release에는 6개 모델군, 18개 모델 변형, 7개 benchmark suite가 포함되어 있었다. 모든 결과는 NVIDIA DGX Spark GB10 한 대에서 llama.cpp를 사용해 측정했다.
Current Findings
- 현재 숫자와 비교 matrix는 Standard Benchmark에서 관리하고, 이 Story는 측정이 쌓이면서 무엇이 바뀌었는지를 설명한다.
- MTP와 non-MTP는 서로 다른 실행 경로이므로, 모델명만으로 속도를 비교하지 않고 variant·quantization·serving 조건을 함께 읽어야 한다.
- 단일 생성 속도와 concurrency 처리량은 다른 지표다. Qwen3.6 TURBO의 c1·c8 결과와 North Mini UD-Q4의 c8 결과가 이를 보여준다.
- Knowledge·Coding·Tool-call·Agent는 서로 다른 protocol을 사용하므로 하나의 종합 점수로 모델 전체를 설명하지 않는다.
Current Highlights
| Model / variant | Mode | Generation | Server throughput |
|---|---|---|---|
| Qwen3.6 35B-A3B TURBO | MTP | TG 77.2 t/s | c1 87.0 · c8 217.3 t/s |
| N2.5 Mini Q4_K_M | non-MTP | TG 81.9 t/s | c1 76.2 · c8 164.9 t/s |
| North Mini UD-Q4 | non-MTP | TG 71.7 t/s | c1 68.5 · c8 299.8 t/s |
| Qwen3.8 Flash Next UD-IQ4_XS | non-MTP | TG 25.8 t/s | c1 26.8 · c8 93.7 t/s |
위 수치는 2026-09-10 Standard Benchmark release의 대표 행이며, 서로 다른 MTP·quantization 조건을 종합 순위처럼 비교하지 않는다.
What Changed
- 현재 benchmark surface는 초기 18개 variant 기록에서 23개 model variant와 7개 suite를 비교하는 Standard matrix로 확장됐다.
- 모델 family 페이지, machine-readable JSON, concurrency c1/c8 지표를 함께 연결해 숫자와 해석의 경계를 분리했다.
- 이 Story의 과거 결과는 조용히 덮어쓰지 않고 milestone으로 남긴다. 현재 결과는 항상 최신 Standard Benchmark에서 확인한다.
Milestones / 시점별 기록
2026-09-10 — Standard Benchmark 전환
- 23개 model variant와 7개 suite를 현재 public matrix로 통합했다.
- Performance·Server-performance·Knowledge·Coding·Tool-call·Agent-single·Agent-multi를 같은 release contract 안에서 구분했다.
- 현재 비교표와 JSON은 이 시점 이후의 최신 숫자를 확인하는 기준이다.
2026-09-06 — 첫 공개 Benchmark
- 18개 GGUF model variant와 초기 evaluator를 공개했다.
- Qwen3.6·Gemma4·Qwen3.8 Flash Next의 속도·coding·tool-call·agent 결과를 한 장비에서 비교했다.
- 아래의 기존 본문과 2026-09-06 JSON은 이 milestone 당시의 조건과 결과를 보존한 기록이다.
Lessons Learned / 누적해서 배운 것
- Dense와 MoE는 모델 크기만으로 GB10 성능을 예상하기 어렵고, 실제 quantization과 runtime 경로를 함께 봐야 한다.
- MTP는 모델 간 순위보다 더 큰 속도 변화를 만들 수 있지만, acceptance와 serving 조건을 같이 기록해야 한다.
- Concurrency 결과는 단일 prompt의 TG 속도와 다른 질문에 답한다. 실제 서빙을 판단할 때 c1·c8을 분리해 읽어야 한다.
- Agent evaluator 결과는 고정 protocol의 관찰값이며, 특정 agent framework에서의 체감 사용성과 동일하지 않다.
Methodology / 측정 기준
최신 측정 환경과 suite contract는 Standard Benchmark에 유지한다. 이 페이지의 아래 본문은 각 시점의 환경·evaluator·실패·해석을 함께 남기는 장기 기록이다.
새 모델이나 runtime 최적화가 추가되면 현재 상태와 Current Highlights를 먼저 갱신하고, 결론이 바뀌거나 의미 있는 변화가 확인될 때만 새 milestone을 추가한다.
Explore the Data
- 최신 Standard Benchmark matrix
- Qwen3.8 Flash Next model detail
- Qwen3.8-27B NVFP4 MTP GGUF 심층 기록
- Local LLM Benchmark Lab
첫 공개 Benchmark의 결론
- 2026년 9월 6일 첫 공개 release는 18개 model variant를 7개 suite에서 비교한 초기 기록이다. 이 숫자와 결론은 당시 evaluator와 조건을 보존한 milestone로 남긴다.
- Performance와 Server-performance는 속도·serving 계측이고, Knowledge·Coding·Tool-call·Agent는 서로 다른 능력을 보는 evaluator다.
- 같은 Qwen3.6 계열 안에서도 quantization과 MTP 설정에 따라 속도와 agent completion이 달라졌다.
- Gemma4는 당시 evaluator에서 Agent-single 12/12를 기록했지만, Agent-multi는 7/10이었다. 하나의 점수로 모델 전체를 설명할 수 없다.
- Qwen3.8 Flash Next는 Knowledge 98/100, Coding 10/12였지만 Agent-single 4/12, Agent-multi 4/10이었다.
- 따라서 “가장 좋은 모델 하나”보다 내 작업에 필요한 suite와 실제 사용 조건을 먼저 보는 편이 맞다.
공개 Benchmark
전체 비교표와 각 모델의 세부 수치는 별도의 Benchmark 페이지에서 확인할 수 있다.
최신 DGX Spark GB10 Standard Benchmark — 23개 model variant 비교
공개 데이터는 사람이 보는 HTML 페이지뿐 아니라 machine-readable JSON으로도 제공한다.
2026-09-06 첫 공개 release JSON 다운로드
2026년 9월 6일 공개 JSON은 당시 상태를 재현하기 위한 milestone 자료다. 최신 수치와 비교할 때는 현재 Standard Benchmark release를 기준으로 읽는다.
| 공개 release 구성 | 값 | 의미 |
|---|---|---|
| Model variants | 18 | 6개 모델군의 GGUF·quantization·tuning 변형 |
| Benchmark suites | 7 | Performance, Server-performance, Knowledge, Coding, Tool-call, Agent-single, Agent-multi |
| Revalidated evaluator runs | 72 | 18개 모델 × Knowledge/Tool-call/Agent 4개 suite |
| Reused source runs | 54 | Performance/Server-performance/Coding의 검증된 source run |
| Total source run references | 126 | 공개 projection이 참조하는 전체 측정 근거 |
| Raw run | 비공개 | 로컬에 보존하고 웹에는 검증된 public projection만 공개 |
테스트 환경
이번 benchmark의 기준 환경은 다음과 같다.
- Hardware: NVIDIA DGX Spark
- GPU/SoC: NVIDIA GB10
- Unified Memory: 128GB
- Backend: llama.cpp
- Model format: GGUF
- Execution: Local
- Evaluator reasoning: OFF
- Raw benchmark run: 로컬 보존
- Public data: 검증된 release snapshot만 공개
Performance와 Server-performance는 모델과 runtime의 속도를 측정하고, 나머지 evaluator는 고정된 dataset과 scorer를 사용한다.
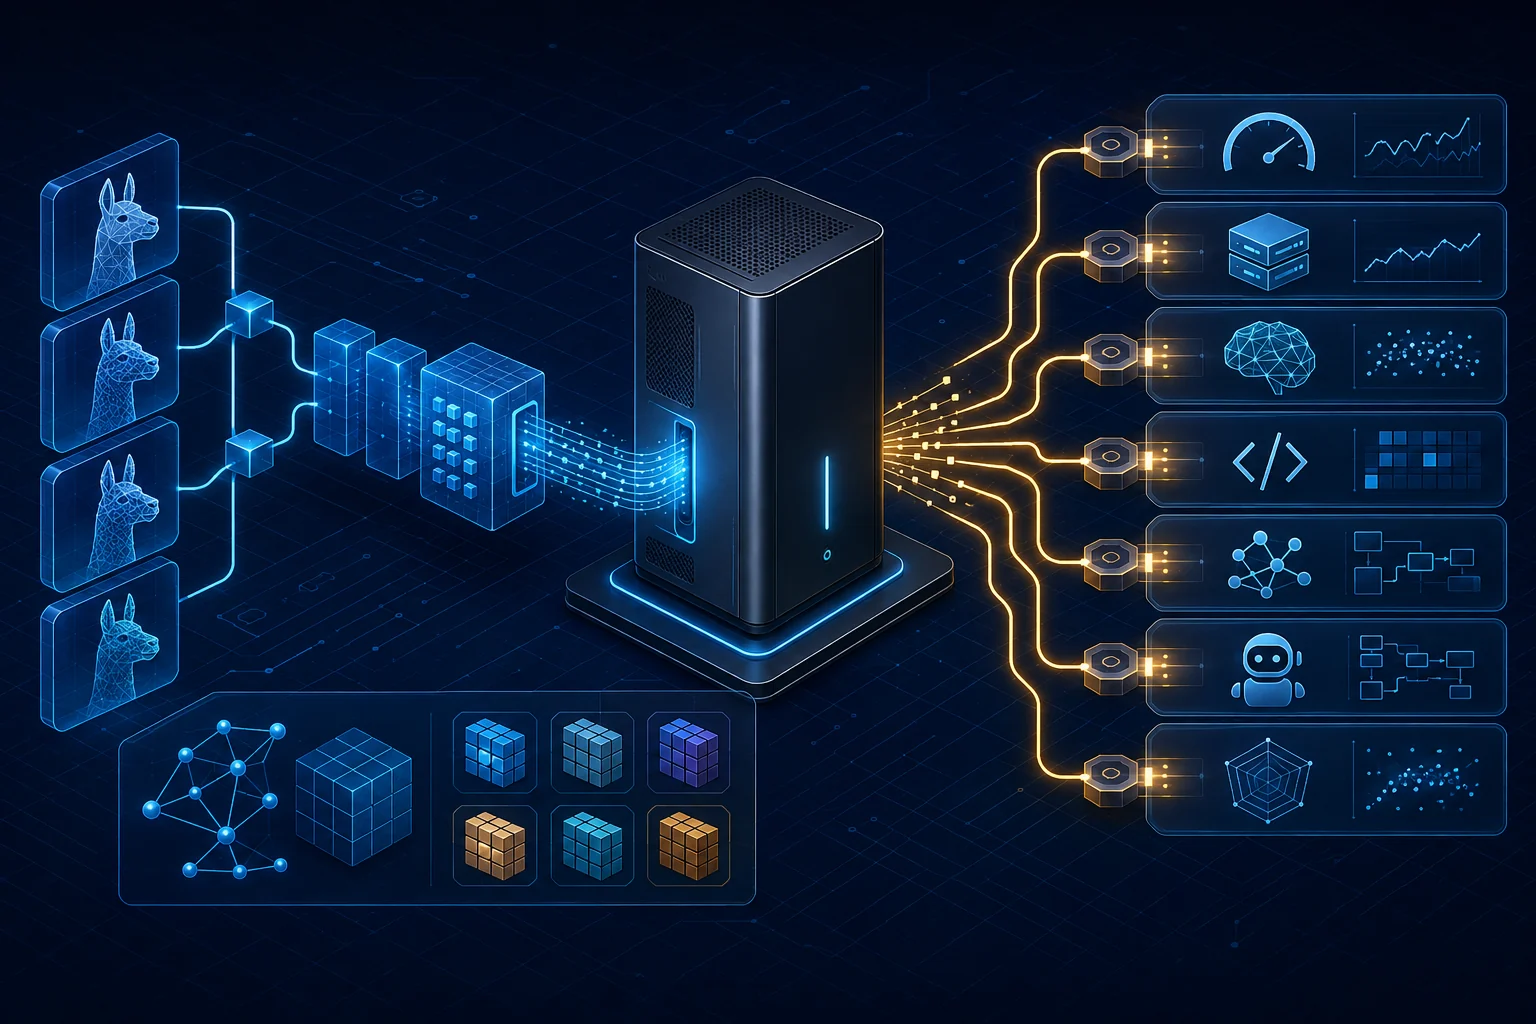
모델마다 quantization, tuning, MTP 지원 여부가 다르기 때문에 결과는 단순히 기반 모델 이름만으로 묶지 않았다. 예를 들어 같은 Qwen3.6이라도 MTP-HQ, MTP-TURBO, Q8_0, APEX-I를 각각 별도의 model variant로 취급했다.
따라서 이 결과는:
Qwen이 Gemma보다 좋다.
같은 일반적인 주장보다는,
이 GGUF variant가 이 GB10 환경에서 이 benchmark recipe로 어떤 결과를 냈는가.
를 보여주는 자료에 가깝다.
이번 release의 evaluator와 scoring contract
첫 공개 release는 모든 suite를 같은 방식으로 뭉뚱그리지 않았다. 기존 성능 계측은 검증된 source run을 재사용했고, Knowledge·Tool-call·Agent 계열은 버전을 고정한 evaluator lane에서 재검증했다.
| Suite | Version | Scoring / measurement | Release lane |
|---|---|---|---|
| Performance | existing-v1 | llama-bench PP/TG tokens/s | 검증된 기존 run 재사용 |
| Server-performance | existing-v1 | concurrency별 throughput·p50/p95 latency·failure rate | 검증된 기존 run 재사용 |
| Knowledge | 1.2 | deterministic normalized answer matching | 18개 모델 재검증 |
| Coding | existing-v1 | 생성 Python 파일의 pytest 실행 | 검증된 기존 run 재사용 |
| Tool-call | 1.1 | tool selection·argument·execution·completion | 18개 모델 재검증 |
| Agent-single | 1.1 | 다단계 task completion·tool 사용·recovery | 18개 모델 재검증 |
| Agent-multi | 1.1 | role participation·handoff·dependency·completion | 18개 모델 재검증 |
이 구분을 해두면 공개 결과를 읽을 때 “모든 점수가 같은 종류의 성능”이라는 오해를 피할 수 있다.
무엇을 측정했나
1. Performance
llama-bench를 이용해 모델 자체의 처리 속도를 측정한다.
Prompt Processing:
- 512 tokens
- 2K tokens
- 8K tokens
- 32K tokens
Text Generation:
- 512 tokens
결과는 tokens/s로 기록한다.
이 테스트는 모델의 지능이나 답변 품질을 평가하지 않는다. 같은 장비에서 모델이 입력을 얼마나 빠르게 처리하고, 실제 토큰을 얼마나 빠르게 생성하는지를 보기 위한 microbenchmark다.
2. Server-performance
llama-server에 모델을 올리고 여러 요청을 동시에 보냈을 때의 serving 성능을 측정한다.
Concurrency는 1, 2, 4, 8로 나누고 다음 지표를 기록한다.
- aggregate throughput
- per-request throughput
- p50 latency
- p95 latency
- failure rate
Performance가 단일 모델의 순수 처리 속도에 가깝다면, Server-performance는 실제 API 형태로 모델을 서비스할 때의 처리 능력을 확인하는 테스트다.
MTP를 지원하는 모델은 MTP 설정을 사용할 수 있고, 지원하지 않는 모델은 non-MTP 조건으로 측정했다. 실행 방식은 결과에 명시적으로 구분한다.
3. Knowledge v1.2
고정된 100문제를 사용한다. 카테고리는 General, Korea, Math, Science, Logic의 5개이며 각 20문제다. 난이도는 easy, medium, hard로 나뉜다.
채점은 LLM judge를 사용하지 않는다.
- Multiple Choice
- Numeric
- Exact Match
형태로 deterministic scoring을 한다. 모든 Knowledge v1.2 run은 reasoning OFF 상태에서 실행한다.
이 dataset은 MMLU 같은 대규모 학술 benchmark를 대체하려는 것이 아니다. 동일 조건에서 모델 간 기본적인 지식·계산·논리 수행 차이를 비교하기 위한 고정 dataset이다.
4. Coding
12개의 작은 Python 구현 문제를 사용한다. factorial, prime 판정, 문자열 처리, 리스트 중복 제거, 빈도 계산, clamp, chunk 처리 같은 독립 함수 구현 문제다.
모델이 작성한 코드를 실제 Python 파일로 저장하고 pytest를 실행한다. 따라서 설명이 그럴듯한지를 보는 것이 아니라, 실제로 실행 가능한 코드를 만들어 테스트를 통과했는가를 측정한다.
다만 이 suite는 실제 대규모 repository 개발 능력을 측정하는 테스트는 아니다. 기초적인 코드 생성과 실행 정확도를 확인하는 benchmark다.
5. Tool-call v1.1
모델이 주어진 도구를 적절하게 선택하고 호출할 수 있는지를 측정한다. 고정 tool simulator에는 계산기, key-value lookup, file read 등이 포함된다.
테스트 유형은 single tool, tool selection, multi-step tool use, recovery, no-tool로 구성된다.
주요 평가 항목은 다음과 같다.
- tool selection
- argument accuracy
- execution success
- final task completion
이 점수는 OpenCode, Claude Code, Codex 같은 특정 agent framework의 전체 능력을 의미하지 않는다. 이번 benchmark에서 정의한 tool schema와 protocol에 대한 수행 결과다.
6. Agent-single v1.1
하나의 agent가 여러 단계의 작업을 연결해서 최종 목표를 달성할 수 있는지 평가한다.
예를 들어 값을 조회하고, 조회 결과를 이용해 계산하고, 파일 내용을 사용하고, 최종 답을 만드는 형태다.
v1.1에서는 중간 tool call이 한 번 실패했더라도 이후 정상적으로 recovery해서 최종 목표를 달성하면 task success로 인정한다. failed tool call 자체는 별도 metric으로 남긴다.
즉 첫 호출의 완벽성보다 작업을 끝까지 완료하는 능력을 본다.
7. Agent-multi v1.1
여러 역할 사이의 handoff가 필요한 고정 evaluator다. 현재 구현에서는 Researcher와 Calculator 같은 역할을 사용한다.
측정 항목은 task completion, role participation, handoff success, required dependency, tool execution, final answer다.
여기서 Agent-multi는 여러 독립 AI 직원이 실제 조직처럼 협업하는 시스템 전체를 의미하지 않는다. 정해진 role/tool handoff protocol 안에서의 수행 능력을 측정한다.
전체 결과를 읽는 방법
공개 페이지에는 18개 모델 변형의 결과를 동일한 matrix로 표시한다. 주요 열은 Model, Performance PP/TG, Server, Knowledge, Coding, Tool-call, Agent-single, Agent-multi다.
서로 다른 성격의 지표를 하나의 총점으로 합치지는 않았다. 빠른 모델과 코딩을 잘하는 모델, tool 사용이 좋은 모델, agent task completion이 좋은 모델은 서로 다를 수 있기 때문이다.
| Model variant | PP / TG | Knowledge | Coding | Tool-call | Agent-single | Agent-multi |
|---|---|---|---|---|---|---|
| Qwen3.6 MTP-HQ | 2091.6 / 68.7 | 94/100 | 10/12 | 11/15 | 11/12 | 8/10 |
| Qwen3.6 MTP-TURBO | 2241.2 / 77.2 | 94/100 | 11/12 | 11/15 | 7/12 | 8/10 |
| Qwen3.6 Q8_0 | 1779.2 / 58.7 | 95/100 | 11/12 | 10/15 | 9/12 | 9/10 |
| Qwen3.6 APEX-I Balanced | 1829.5 / 68.5 | 95/100 | 10/12 | 11/15 | 9/12 | 9/10 |
| Gemma4 NVFP4 | 2609.5 / 37.4 | 98/100 | 4/12 | 11/15 | 12/12 | 7/10 |
| Gemma4 Q4_0 | 2516.3 / 51.7 | 98/100 | 3/12 | 12/15 | 12/12 | 7/10 |
| Qwen3.8 Flash Next UD-IQ4_XS | 280.1 / 25.8 | 98/100 | 10/12 | 10/15 | 4/12 | 4/10 |
PP/TG는 각각 prompt processing과 text generation tokens/s다. 위 표는 전체 leaderboard가 아니라, 본문에서 설명한 variant 차이를 보여주는 대표 행이다. 전체 18개 모델의 원자료는 최신 Standard matrix에서 확인할 수 있다.
Qwen3.6 — 같은 계열 안에서도 성격이 달랐다
재검증된 evaluator 결과만 놓고 보면 Qwen3.6 계열의 Knowledge와 Tool-call 점수는 서로 크게 벌어지지 않았다. 그런데 Agent-single과 Agent-multi에서 variant별 차이가 보였다.
MTP-HQ
- Knowledge: 94/100
- Tool-call: 11/15
- Agent-single: 11/12
- Agent-multi: 8/10
MTP-TURBO
- Knowledge: 94/100
- Tool-call: 11/15
- Agent-single: 7/12
- Agent-multi: 8/10
Q8_0
- Knowledge: 95/100
- Tool-call: 10/15
- Agent-single: 9/12
- Agent-multi: 9/10
APEX-I Balanced
- Knowledge: 95/100
- Tool-call: 11/15
- Agent-single: 9/12
- Agent-multi: 9/10
MTP-TURBO는 속도 측면에서 매우 매력적이었지만 Agent-single은 HQ보다 낮았다. 반대로 Q8_0과 APEX-I는 Agent-multi에서 9/10을 기록했다.
가장 빠른 variant와 가장 높은 task completion을 보이는 variant가 항상 같지는 않았다.
Gemma4 — 예상보다 Agent-single이 강했다
Gemma4 QAT 두 variant는 Knowledge에서 98/100을 기록했고, Agent-single에서는 모두 12/12를 기록했다.
NVFP4
- Knowledge: 98/100
- Tool-call: 11/15
- Agent-single: 12/12
- Agent-multi: 7/10
Q4_0
- Knowledge: 98/100
- Tool-call: 12/15
- Agent-single: 12/12
- Agent-multi: 7/10
개인적으로는 특정 agent harness에서 Gemma의 tool-call을 편하게 사용하지 못했던 경험이 있다. 하지만 이번 benchmark에서는 높은 task completion을 기록했다.
이 차이는 benchmark 결과를 해석할 때 중요한 부분이다. 모델의 고정 evaluator 점수와 특정 agent framework에서의 실제 사용성은 같은 개념이 아니다. chat template, tool schema, parser, harness 구현 방식에 따라 체감은 달라질 수 있다.
Qwen3.8 Flash Next — 큰 모델이라고 모든 항목이 높지는 않았다
이번에 사용한 모델은 Qwen3.8 Flash Next UD-IQ4_XS multipart GGUF였다. 파일 크기는 약 88~90GB 수준이었다.
재검증 결과는 다음과 같다.
- Knowledge: 98/100
- Coding: 10/12
- Tool-call: 10/15
- Agent-single: 4/12
- Agent-multi: 4/10
Knowledge와 Coding은 높은 편이었지만 Agent 계열에서는 낮은 결과가 나왔다. 실제로 다른 환경에서 이 모델을 코딩 작업에 사용했을 때의 체감은 이 결과보다 좋았다.
따라서 이번 결과만으로 Qwen3.8 Flash Next 전체의 agent capability를 일반화하기는 어렵다. 가능한 변수는 이번에 사용한 UD-IQ4_XS quantization, 고정 tool protocol, 실제 coding harness와 synthetic evaluator의 차이다.
그래서 공개 결과에는 기반 모델 이름뿐 아니라 정확한 variant와 quantization을 함께 기록한다.
벤치마크도 한 번 잘못됐다
이번 결과가 처음부터 정상적으로 나온 것은 아니다.
초기 evaluator에서는 reasoning과 scorer 구현에 문제가 있었다. 일부 모델은 <think> reasoning을 먼저 생성했는데 output budget이 작아 최종 답에 도달하기 전에 잘리는 문제가 있었다.
또 객관식과 숫자형 문제를 실제 dataset type으로 매핑하기 전에 scorer가 모든 문제를 exact match로 처리하는 오류도 발견했다.
예를 들어 모델이:
The capital of France is Paris.
라고 정확하게 답해도 expected value가 B라면 전체 문자열 exact match에서 실패했다. 수학 문제에서도:
2 + 3 × 4 = 14
처럼 정답을 포함한 정상 응답이 그대로 오답 처리됐다.
이 오류 때문에 한 validation run에서는 Knowledge가 4/100으로 기록됐다. raw response를 직접 확인한 뒤 scorer를 수정하고 같은 모델을 다시 실행하자 결과는 85/100으로 바뀌었다.
이후 최종 공개 evaluator는 다음 기준으로 다시 검증했다.
- reasoning OFF
- Knowledge v1.2
- Tool-call v1.1
- Agent-single v1.1
- Agent-multi v1.1
- deterministic scorer
- recovery-aware agent scoring
- raw evidence preservation
기존의 잘못된 run을 덮어쓰지는 않았다. historical artifact로 그대로 보존하고 새로운 Run ID로 재측정했다.
첫 공개 release에는 72개의 재검증 evaluator run이 포함됐고, 기존 Performance / Server-performance / Coding 결과는 검증된 source run을 재사용했다. 전체 공개 release는 총 126개의 source run reference로 추적된다.
이 결과를 어떻게 읽어야 하나
이 benchmark는 절대적인 LLM leaderboard가 아니다.
정확한 질문은 다음과 같다.
NVIDIA DGX Spark GB10에서 특정 GGUF variant를 동일한 llama.cpp 환경과 고정된 benchmark recipe로 실행했을 때 어떤 결과가 나오는가?
따라서 몇 가지 제한이 있다.
Hardware
Performance와 Server-performance는 다른 GPU나 runtime에서 달라진다.
Quantization
같은 기반 모델이라도 quantization이 성능과 품질에 영향을 줄 수 있다.
Tool / Agent protocol
현재 Tool-call과 Agent suite는 고정된 synthetic protocol을 사용한다. 실제 OpenCode, Claude Code, Codex 등의 coding agent 성능과 동일한 결과를 보장하지 않는다.
Knowledge dataset
100문제는 모델의 전체 지식을 대표하지 않는다. 동일 조건 비교를 위한 고정 dataset이다.
총점 없음
7개 suite가 서로 다른 능력을 측정하기 때문에 임의의 종합 점수는 만들지 않았다.
공개 데이터와 재현성
이번 benchmark는 결과만 공개하는 것보다 측정 방법과 데이터 구조를 함께 공개하는 것을 중요하게 생각했다.
첫 공개 release에는 다음 정보가 포함됐다.
- 18개 model variants
- 7개 benchmark suites
- evaluator version
- dataset SHA256
- 모델별 결과
- source run ID
- measurement environment
- llama.cpp build/commit
- methodology
- limitations
개인 로컬 경로, credential, raw private artifact 등은 공개하지 않는다. raw evidence는 로컬에 보존하고, 웹에는 검증된 public projection만 제공한다.
Machine-readable JSON
웹의 비교표와 같은 release를 JSON으로도 공개한다. 이를 이용하면 직접 모델별 비교, quantization 비교, suite별 ranking, 별도 chart, 데이터 분석 등을 만들 수 있다.
공개 JSON 역시 동일 release ID에 대해 immutable snapshot으로 관리한다.
그래서 어떤 모델이 가장 좋은가?
이번 결과에서도 하나의 답은 나오지 않았다.
빠른 모델이 필요하다면 Performance와 Server-performance가 중요하다. 코딩이 중요하다면 Coding 결과를 봐야 한다. 로컬 agent worker가 필요하다면 Tool-call과 Agent-single을 같이 보는 편이 낫다. 여러 역할의 handoff가 중요하다면 Agent-multi 결과도 참고할 수 있다.
내가 이번 benchmark에서 알고 싶었던 것도 결국 이것이었다.
가장 높은 종합 점수를 가진 모델이 무엇인가가 아니라, 내 장비와 내 작업에 어떤 모델이 맞는가.
같은 모델 계열 안에서도 quantization과 tuning에 따라 꽤 다른 결과가 나왔다. 모델 카드에서 예상했던 것과 실제 GB10에서 실행했을 때의 결과가 항상 일치하지도 않았다.
이 페이지는 그 차이가 시간에 따라 어떻게 달라졌는지를 기록하는 living benchmark report다.
관련 글과 다음 단계
최신 전체 표와 methodology는 Standard Benchmark에서 확인한다. 이 글 아래의 표와 JSON은 2026-09-06 milestone 당시의 기록이다. benchmark 시스템 자체의 프로젝트 맥락은 Local LLM Benchmark Lab에 정리되어 있다.
- NVIDIA DGX Spark GB10에서 GGUF 모델을 비교했던 초기 benchmark 기록
- Nex-N2-mini GGUF quantization 비교
- North Mini Code GGUF benchmark
- Gemma4 MTP와 DGX Spark 실전 측정 기록
- Qwen3.6 llama.cpp·vLLM·DFlash 실전 비교
벤치마크를 만들고 수정하면서 생긴 시행착오와 하루 종일 모델을 돌린 과정은 별도의 Story에서 더 자세히 정리할 예정이다.