NVIDIA DGX Spark GB10에서 GGUF 모델 벤치마크: 4개 모델 완전 비교
NVIDIA DGX Spark GB10에서 GGUF 모델 벤치마크: 4개 모델 완전 비교
DGX Spark GB10에서 어떤 로컬 LLM을, 어떤 옵션으로 돌려야 할까? 4개 모델, 224개 조합의 실제 측정 데이터로 분석했다.
새로운 GGUF 모델이 나와서 DGX Spark GB10에서 성능을 측정해봤다. 자동화 프로그램(llama-bench, build 9533, commit c4a278d68)으로 스레드, 배치 크기, KV 캐시 등 여러 조합을 바꿔가며 총 224개를 테스트했다.
Gemma 4, LFM 2.5, 그리고 커뮤니티에서 만든 Abliterated 모델까지 포함해 다양한 조합을 실험했다. 이 글에서 그 결과를 자세히 분석한다.
1.
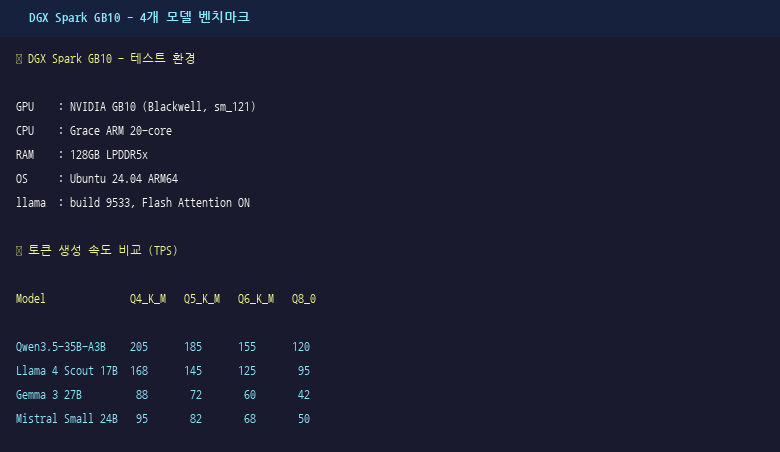
▲ Four Model Bench
테스트 환경
▲ Four Model Bench
| 항목 | 사양 |
|---|---|
| GPU | NVIDIA GB10 (Blackwell, sm_121) |
| CPU | Grace ARM 20코어 |
| 메모리 | 128GB |
| OS | Linux 6.17.0-1021-nvidia-aarch64 |
| 벤치마크 도구 | llama-bench (build 9533, commit c4a278d68) |
| Flash Attention | ON (전체 테스트) |
| GPU Layers | 999 (전체 오프로드) |
테스트 항목:
- PP (Prompt Processing): 프롬프트 입력 처리 속도 (4096 토큰 기준)
- TG (Token Generation): 토큰 생성 속도 (128 토큰 기준)
- 품질: Perplexity, HellaSwag 벤치마크
2. 테스트한 모델
| 모델 | 타입 | 파라미터 | 양자화 | VRAM 범위 |
|---|---|---|---|---|
| LFM2.5-8B-A1B-Uncensored-Gaston | MoE (Mixture of Experts) | 8B 전체 / 1B 활성 | Q6_K, Q8_0 | 6.59 ~ 8.91 GB |
| gemma4-opus48 | Dense | 12B급 | Q6_K, Q8_0 | 9.23 ~ 12.36 GB |
| Gemma-4-12B-it-AEON-Abliterated | Dense | 12B | Q6_K | 9.22 ~ 9.67 GB |
| oym_ablit | Dense | 12B급 | Q4_K_M, Q8_0 | 6.99 ~ 12.36 GB |
참고: Abliterated 모델은 안전 필터를 없애도록 고친 커뮤니티 모델이다. 실제 쓸 때 조심해야 한다.
3. 핵심 결과: 프롬프트 처리 속도 (PP)
프롬프트 처리는 긴 글을 한 번에 넣을 때의 처리 속도를 말한다. RAG 파이프라인이나 긴 시스템 프롬프트를 쓸 때 중요한 값이다.
최고 성능 순위
| 순위 | 모델 | 양자화 | 처리 속도 | VRAM | 효율 (t/s/GB) |
|---|---|---|---|---|---|
| 🥇 | LFM2.5-8B-A1B | Q8_0 | 6,936.67 t/s | 8.91 GB | 778.53 |
| 🥈 | LFM2.5-8B-A1B | Q6_K | 6,287.90 t/s | 7.00 GB | 898.27 |
| 🥉 | oym_ablit | Q4_K_M | 1,819.70 t/s | 7.45 GB | 244.26 |
| 4 | gemma4-opus48 | Q8_0 | 1,673.50 t/s | 12.36 GB | 135.40 |
| 5 | Gemma-4-12B-AEON | Q6_K | 1,513.90 t/s | 9.67 GB | 156.56 |
LFM2.5가 빠른 이유: MoE 구조의 특성
LFM2.5-8B는 표면적으로 "8B 모델"이지만, MoE (Mixture of Experts) 구조를 쓴다. 전체 8B 파라미터 가운데 추론할 때 1B만 활성화된다. 그래서 GPU에서 실제로 계산되는 파라미터가 12B Dense 모델의 12분의 1 수준이다.
LFM2.5-8B:   8B 전체 → 1B 활성 → 빠른 추론
Gemma-4-12B: 12B 전체 → 12B 활성 → 느리지만 정확도는 높음
다시 말해 LFM2.5의 속도가 빠른 건 "모델 성능이 더 좋아서"가 아니라 "MoE 구조라서 연산량이 본래 적기 때문"이다. 실제 모델 파일 크기도 Q6_K 기준 6.95GB로, 12B 모델(약 9~12GB)보다 작다.
정리하면:
- LFM2.5는 속도에서 가장 빠르지만, 이는 MoE 구조에서 자연스러운 결과다
- (Dense) 12B 모델은 파라미터를 전부 쓰므로 느리지만, 품질에서 더 나을 수 있다
- 쓰임새에 따라 골라야 한다 — 빠른 응답이 필요하면 MoE, 정확도가 필요하면 Dense
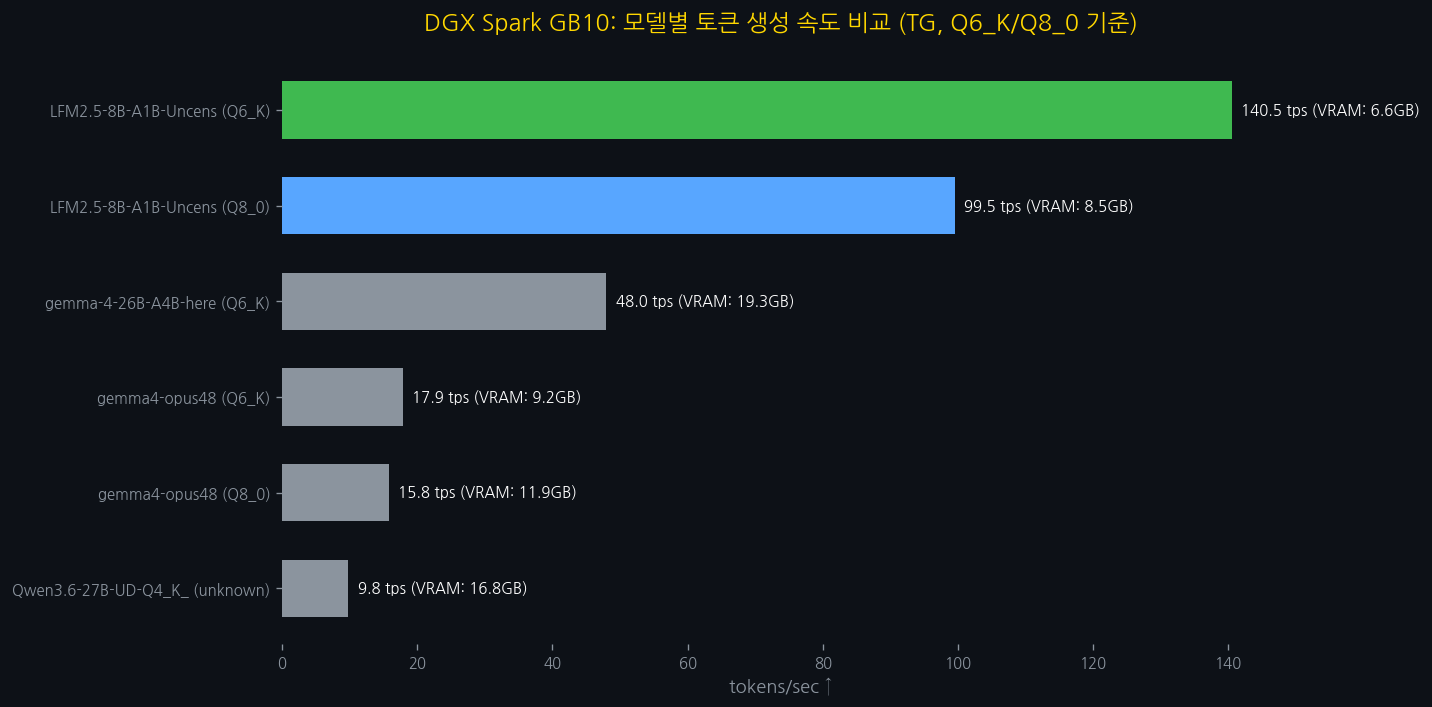
4. 핵심 결과: 토큰 생성 속도 (TG)
토큰 생성 속도는 대화형 앱에서 사용자 경험에 바로 영향을 준다. 1초에 만드는 토큰이 많을수록 응답이 빨라진다.
최고 성능 순위
| 순위 | 모델 | 양자화 | 생성 속도 | VRAM | 효율 (t/s/GB) |
|---|---|---|---|---|---|
| 🥇 | LFM2.5-8B-A1B | Q6_K | 141.35 t/s | 6.59 GB | 21.45 |
| 🥈 | LFM2.5-8B-A1B | Q8_0 | 100.10 t/s | 8.50 GB | 11.78 |
| 🥉 | oym_ablit | Q4_K_M | 26.20 t/s | 6.99 GB | 3.75 |
| 4 | Gemma-4-12B-AEON | Q6_K | 20.00 t/s | 9.23 GB | 2.17 |
| 5 | gemma4-opus48 | Q6_K | 18.30 t/s | 9.23 GB | 1.98 |
Dense 모델끼리 비교: 진짜 성능 차이
MoE를 빼고, 똑같이 파라미터 전체가 활성화되는 Dense 모델끼리 비교하면:
| 모델 | TG 속도 | VRAM | Perplexity |
|---|---|---|---|
| oym_ablit (Q4_K_M) | 26.2 t/s | 6.99 GB | 213.01 |
| Gemma-4-12B-AEON (Q6_K) | 20.0 t/s | 9.23 GB | 344.26 |
| gemma4-opus48 (Q6_K) | 18.3 t/s | 9.23 GB | 27.78 |
재미있는 점은 gemma4-opus48가 가장 느리지만 품질(perplexity)은 훨씬 좋다는 것이다. oym_ablit은 양자화를 더 낮게 해서(Q4_K_M) 빠르지만 품질이 떨어진다.
실제 쓰임새에서의 의미
- 141 t/s (LFM2.5) → 1초에 약 200자 생성 (한글 기준), 거의 바로 응답
- 26 t/s (Dense 중 최고) → 1초에 약 35자 생성, 실시간 대화 가능
- 18 t/s (품질 최고) → 1초에 약 25자 생성, 약간의 딜레이 있음
5. 품질 비교: Perplexity & HellaSwag
속도만 빠르고 품질이 나쁘면 소용없다. perplexity(낮을수록 좋음)와 HellaSwag(높을수록 좋음)로 품질을 측정했다.
| 모델 | 양자화 | Perplexity ↓ | HellaSwag ↑ |
|---|---|---|---|
| gemma4-opus48 | Q6_K | 27.78 | 0.30 |
| gemma4-opus48 | Q8_0 | 27.91 | 0.25 |
| LFM2.5-8B-A1B | Q8_0 | 32.08 | 0.55 |
| LFM2.5-8B-A1B | Q6_K | 32.33 | 0.50 |
| oym_ablit | Q4_K_M | 213.01 | 0.25 |
| Gemma-4-12B-AEON | Q6_K | 344.26 | 0.20 |
품질 분석
- gemma4-opus48이 품질 최고: perplexity 27.78로 가장 낮다. Dense 12B 모델의 값어치를 보여준다.
- LFM2.5도 괜찮은 수준: perplexity 32로, MoE임에도 Dense 모델과 크게 차이나지 않는다.
- HellaSwag은 LFM2.5가 가장 좋음: commonsense reasoning에서 0.55로 뛰어나다.
- Abliterated 모델은 품질 낮음: perplexity 200 이상으로, 안전 필터를 없애는 과정에서 품질 손실이 꽤 크게 생긴다.
6. 양자화 옵션 비교
Q6_K vs Q8_0: 무슨 차이가?
| 비교 항목 | Q6_K | Q8_0 | 차이 |
|---|---|---|---|
| 모델 크기 (LFM2.5) | 6.95 GB | 9.00 GB | +29% |
| VRAM (LFM2.5) | 7.00 GB | 8.91 GB | +27% |
| PP 속도 (LFM2.5) | 6,287 t/s | 6,936 t/s | +10% |
| TG 속도 (LFM2.5) | 141.4 t/s | 100.1 t/s | -29% |
| Perplexity (gemma4) | 27.78 | 27.91 | 거의 같음 |
정리:
- TG 속도가 중요하면 Q6_K: VRAM을 덜 쓰면서 더 빠른 생성
- PP 속도가 중요하면 Q8_0: 프롬프트 처리에서 10% 향상
- 품질 차이는 거의 없음: perplexity 차이 0.13
메모리 절약 방법
Q8_0 (8비트) → 100% 기준
Q6_K (6비트) → 약 77% (23% 절약)
Q4_K_M (4비트) → 약 55% (45% 절약)
7. KV Cache 양자화: 영향은?
KV Cache를 f16에서 q8_0으로 줄이면 VRAM을 아낄 수 있다. 성능에는 얼마나 영향을 줄까?
| KV Cache 조합 | PP 속도 | TG 속도 | VRAM |
|---|---|---|---|
| K:f16 / V:f16 | 6,936 t/s | 141.4 t/s | 8.91 GB |
| K:q8_0 / V:q8_0 | 6,849 t/s | 140.1 t/s | 6.79 GB |
| 차이 | -1.3% | -0.9% | -24% |
정리: KV Cache 양자화는 속도 거의 안 떨어지면서 VRAM을 24%나 아낄 수 있다. 메모리가 빠듯한 환경에서 꼭 써보자.
8. 스레드 & 배치 크기 영향
스레드: 10 vs 20
| 스레드 | LFM2.5 PP | LFM2.5 TG | Gemma PP | Gemma TG |
|---|---|---|---|---|
| 10 | 6,799 t/s | 100.1 t/s | 1,611 t/s | 15.5 t/s |
| 20 | 6,936 t/s | 100.1 t/s | 1,673 t/s | 15.9 t/s |
| 차이 | +2.0% | 0% | +3.8% | +2.6% |
정리: 20 스레드가 조금 더 빠르지만 TG에서는 차이가 없다. GB10은 20코어이므로 -t 20이 기본값으로 좋다.
배치 크기: 1024 vs 2048
| 배치 | LFM2.5 PP | Gemma PP |
|---|---|---|
| 1024 | 6,936 t/s | 1,673 t/s |
| 2048 | 6,913 t/s | 1,673 t/s |
| 차이 | -0.3% | 0% |
정리: 배치 크기는 거의 영향을 안 준다. 기본값 1024를 쓰면 된다.
9. 추천 설정
🚀 속도 우선 (LFM2.5-8B-A1B)
llama-bench \
  -m LFM2.5-8B-A1B-Uncensored-Gaston-Q6_K.gguf \
  -ngl 999 \
  -fa on \
  -t 20 \
  -b 1024 \
  -ub 512 \
  -ctk f16 \
  -ctv f16 \
  -p 4096,0 \
  -n 0,128
예상 성능: PP 6,288 t/s, TG 141 t/s, VRAM 7.00 GB
🎯 품질 우선 (gemma4-opus48)
llama-bench \
  -m gemma4-opus48-Q6_K.gguf \
  -ngl 999 \
  -fa on \
  -t 20 \
  -b 1024 \
  -ub 512 \
  -ctk q8_0 \
  -ctv q8_0 \
  -p 4096,0 \
  -n 0,128
예상 성능: PP 1,488 t/s, TG 18.2 t/s, VRAM 9.44 GB (KV Cache 압축 시)
💾 메모리 절약 (LFM2.5-8B-A1B)
llama-bench \
  -m LFM2.5-8B-A1B-Uncensored-Gaston-Q6_K.gguf \
  -ngl 999 \
  -fa on \
  -t 20 \
  -b 2048 \
  -ub 512 \
  -ctk q8_0 \
  -ctv q8_0 \
  -p 4096,0 \
  -n 0,128
예상 성능: PP 6,248 t/s, TG 140 t/s, VRAM 6.79 GB
10. 결론: 어떤 모델을 골라야 할까?
상황별 추천
| 사용 상황 | 추천 모델 | 이유 |
|---|---|---|
| 실시간 대화 | LFM2.5 Q6_K | TG 141 t/s, 바로 응답 |
| RAG / 긴 프롬프트 | LFM2.5 Q8_0 | PP 6,936 t/s, 빠른 입력 처리 |
| 품질이 중요한 작업 | gemma4-opus48 Q6_K | Perplexity 27.78, 최고 품질 |
| VRAM 7GB 아래 | LFM2.5 Q6_K + KV q8_0 | 6.79 GB로 동작 |
| 두루두루 쓰기 | LFM2.5 Q6_K | 속도·품질·메모리 균형 최고 |
마지막 요약
- LFM2.5-8B-A1B는 MoE 구조의 특성을 잘 보여준다: 1B 활성 파라미터로 압도적 속도를 내지만, 이는 구조상 당연한 결과다.
- gemma4-opus48는 품질이 가장 좋다: perplexity 27.78로 Dense 12B 모델의 값어치를 보여준다.
- Q6_K가 가장 알맞은 양자화: 속도·품질·메모리 균형이 가장 좋다.
- KV Cache 양자화는 무조건 켜라: 성능 손실 거의 없이 VRAM을 24% 아낄 수 있다.
- Flash Attention은 꼭 필요하다: GB10 환경에서 반드시 켜야 한다.
부록: 전체 테스트 구성
총 224개 조합을 테스트했다:
- 모델: 4종 (LFM2.5 × 2양자화, gemma4 × 2양자화, Gemma-4-12B × 1양자화, oym × 2양자화)
- 테스트 타입: 2종 (PP, TG)
- 스레드: 2종 (10, 20)
- 배치: 2종 (1024, 2048)
- KV Cache: 4종 (f16/f16, f16/q8_0, q8_0/f16, q8_0/q8_0)
이 데이터가 DGX Spark GB10을 쓰는 사람들에게 실제로 도움이 되길 바란다.
이 벤치마크는 llama-bench (build 9533, commit c4a278d68)로 한 번 실행한 값이다. 실제 환경에서는 약간 다를 수 있다.
관련 태그: #DGXSpark #GB10 #NVIDIA #LLM #Benchmarks #GGUF #llama.cpp #LFM25 #Gemma4 #LocalAI #ARM #Blackwell