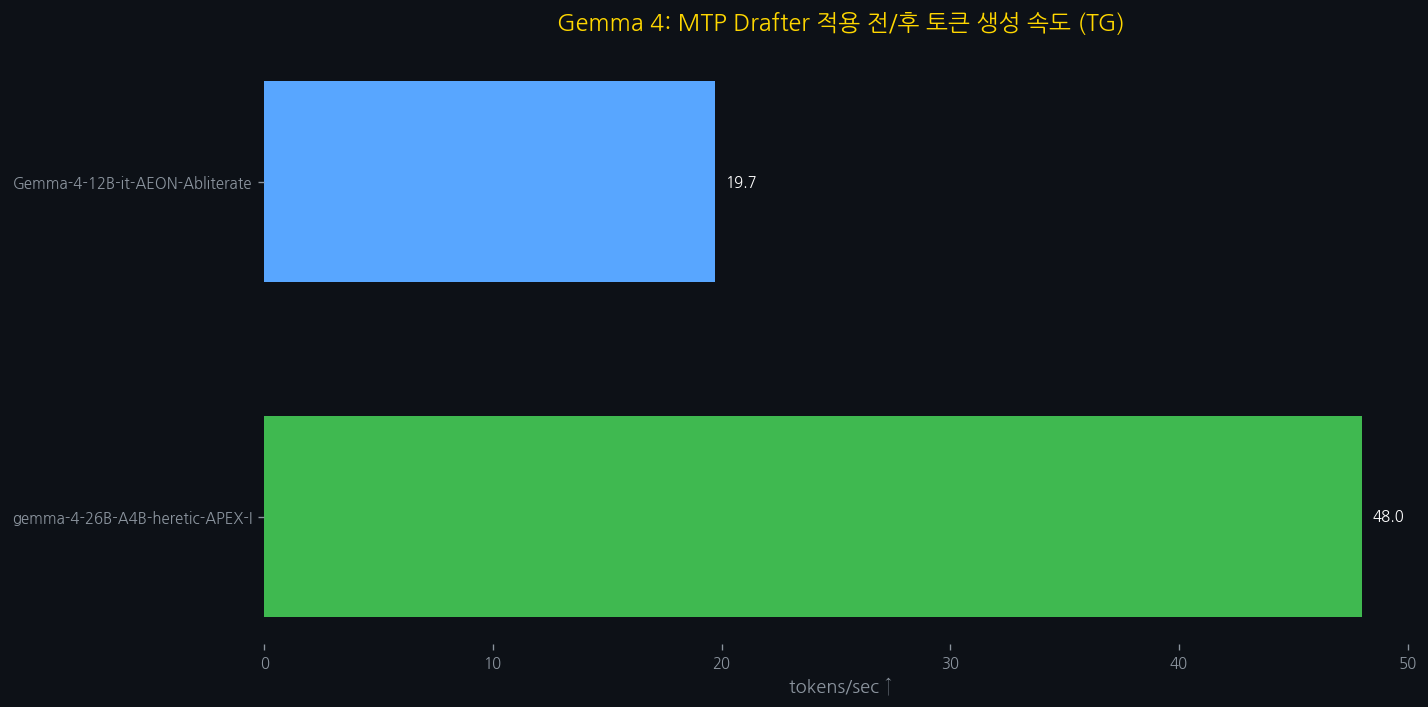
Gemma 4 MTP Drafter 실전 적용기 — DGX Spark에서 3배 빨라진 31B
핵심 결과
| 모델 | 프레임워크 | Baseline | + MTP γ=4 | 속도 향상 |
|---|---|---|---|---|
| Gemma 4 26B-A4B (FP8) | vLLM | 37.3 tok/s | 62.9 tok/s | 1.69x |
| Gemma 4 31B Dense (NVFP4) | vLLM | 6.5 tok/s | 18.8 tok/s | 2.89x |
| Gemma 4 26B-A4B (Q8_0) | llama.cpp | 45.4 tok/s (MTP 미지원) | — | |
| Gemma 4 31B Dense (Q6_K_XL) | llama.cpp | 6.8 tok/s (MTP 미지원) | — | |
| Gemma 4 31B Dense (NVFP4-turbo) | llama.cpp | 10.6 tok/s (MTP 미지원) | — | |
870MB짜리 Drafter 하나 추가로 Dense 31B가 6.5 → 18.8 tok/s. 모델 교체 없이, 학습 없이, 품질 저하 없이. DGX Spark 사용자라면 안 쓸 이유가 없다.
MTP가 뭔가
일반적인 LLM은 토큰을 하나씩 순차 생성한다. GPU 연산 능력은 남아돌지만 메모리 대역폭이 병목이 되어, 대부분의 시간을 가중치를 메모리에서 읽어오는 데 쓴다.
DGX Spark의 LPDDR5X는 273 GB/s — H100의 3.35 TB/s 대비 12분의 1이라 이 병목이 특히 심하다. 한 토큰 생성하려면 모델 전체 가중치를 한 번 읽어야 하니까:
이론적 최대 속도 = 메모리 대역폭 ÷ 활성 모델 크기

31B BF16:  273 GB/s ÷ 62 GB ≈ 4.4 tok/s
26B-A4B:   273 GB/s ÷ ~8 GB(활성) ≈ 34 tok/s
MTP(Multi-Token Prediction) Drafter는 이 병목을 정확히 공략한다:
- 작고 빠른 Drafter가 여러 토큰을 미리 예측
- 큰 Target 모델이 한 번의 forward pass로 전부 검증
- 맞으면 수락, 틀리면 그 지점부터 Target이 직접 생성
한 번 가중치를 읽는 동안 여러 토큰을 확정하니, 대역폭 병목인 환경일수록 효과가 극대화된다. DGX Spark이 정확히 그 환경이다.
Gemma 4 MTP의 특별한 점
기존 speculative decoding(별도 작은 모델 사용)과 다른 점이 세 가지 있다:
KV Cache 공유 — Drafter가 Target의 KV cache를 그대로 쓴다. 컨텍스트를 다시 계산할 필요 없음.
Target Activation 활용 — Drafter가 Target의 마지막 레이어 활성화를 입력으로 받는다. Target이 이미 "생각한 것"을 참고하니 예측 정확도가 높다.
공유 임베딩 — Drafter와 Target이 같은 임베딩 테이블을 쓴다.
이 덕분에 Drafter가 극히 작아도(26B용 ~870MB, 31B용 ~930MB) 높은 수락률을 달성한다.
환경
Hardware: NVIDIA DGX Spark (GB10 Grace Blackwell)
Memory:   128 GB LPDDR5X (~273 GB/s)
CUDA:     13.0 (driver 580.x)
OS:       Ubuntu 24.04, aarch64
vLLM:     0.20.2rc1 (gemma4-0505 preview)
llama.cpp: latest main (2026-05-06)
모델 준비
# 26B MoE — FP8 instruction-tuned (RedHat)
hf download RedHatAI/gemma-4-26B-A4B-it-FP8-Dynamic \
  --local-dir ./models/gemma4-26b-a4b-it-fp8

# 26B MTP Drafter (~870MB)
hf download google/gemma-4-26B-A4B-it-assistant \
  --local-dir ./models/gemma4-26b-a4b-it-assistant

# 31B Dense — NVFP4
hf download nvidia/Gemma-4-31B-IT-NVFP4 \
  --local-dir ./models/gemma4-31b-it-nvfp4

# 31B MTP Drafter (~930MB)
hf download google/gemma-4-31B-it-assistant \
  --local-dir ./models/gemma4-31b-it-assistant
huggingface-cli download는 deprecated됐으니 hf download를 사용한다.
vLLM 실행: 패치 적용
Preview Docker 이미지는 양자화 모델에서 버그 2개가 있다. PR #41745 head에서 수정된 파일을 bind-mount 해야 한다.
# 패치 파일 다운로드
wget https://raw.githubusercontent.com/vllm-project/vllm/d8b3826648da6b407f8c55457a2103be9aeb5d83/vllm/model_executor/models/gemma4_mtp.py \
  -O /tmp/gemma4_mtp.py

# Docker 이미지
docker pull vllm/vllm-openai:gemma4-0505-arm64-cu130
실험 1: 26B MoE (FP8)
Baseline (MTP 없이)
docker run -d --name gemma4-baseline \
  --gpus all --ipc host --shm-size 64gb \
  -p 8080:8000 \
  -v /media/kahros/backup/gemma4_mtp/models:/models \
  vllm/vllm-openai:gemma4-0505-arm64-cu130 \
  --model /models/gemma4-26b-a4b-it-fp8 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.70 \
  --max-model-len 4096 \
  --limit-mm-per-prompt '{"image":0,"audio":0,"video":0}'
MTP 적용 (γ=4)
docker run -d --name gemma4-mtp \
  --gpus all --ipc host --shm-size 64gb \
  -p 8080:8000 \
  -v /media/kahros/backup/gemma4_mtp/models:/models \
  -v /tmp/gemma4_mtp.py:/usr/local/lib/python3.12/dist-packages/vllm/model_executor/models/gemma4_mtp.py:ro \
  vllm/vllm-openai:gemma4-0505-arm64-cu130 \
  --model /models/gemma4-26b-a4b-it-fp8 \
  --speculative-config '{"method":"mtp","model":"/models/gemma4-26b-a4b-it-assistant","num_speculative_tokens":4}' \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.7 \
  --max-model-len 4096 \
  --limit-mm-per-prompt '{"image":0,"audio":0,"video":0}'
결과
| 구성 | 코딩 (Red-Black Tree) | 설명 (Transformer) | 실측 | 평균 |
|---|---|---|---|---|
| Baseline | 36.6 tok/s | 37.6 tok/s | 37.7 tok/s | 37.3 tok/s |
| + MTP γ=4 | 72.5 tok/s | 64.0 tok/s | 52.1 tok/s | 62.9 tok/s |
| 향상 | 1.98x | 1.70x | 1.38x | 1.69x |
코딩 작업(반복적 패턴이 많음)에서 거의 2배, 한국어(토큰 다양성 높음)에서도 1.38배. 평균 1.69배 향상. 870MB 추가로 이 정도면 가성비 끝판왕이다.
실험 2: 31B Dense (NVFP4)
Baseline
docker run -d --name gemma4-31b-baseline \
  --gpus all --ipc host --shm-size 64gb \
  -p 8080:8000 \
  -v /media/kahros/backup/gemma4_mtp/models:/models \
  vllm/vllm-openai:gemma4-0505-arm64-cu130 \
  --model /models/gemma4-31b-it-nvfp4 \
  --quantization modelopt \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.7 \
  --max-model-len 4096 \
  --limit-mm-per-prompt '{"image":0,"audio":0,"video":0}'
MTP 적용 (γ=4)
docker run -d --name gemma4-31b-mtp \
  --gpus all --ipc host --shm-size 64gb \
  -p 8080:8000 \
  -v /media/kahros/backup/gemma4_mtp/models:/models \
  -v /tmp/gemma4_mtp.py:/usr/local/lib/python3.12/dist-packages/vllm/model_executor/models/gemma4_mtp.py:ro \
  vllm/vllm-openai:gemma4-0505-arm64-cu130 \
  --model /models/gemma4-31b-it-nvfp4 \
  --speculative-config '{"method":"mtp","model":"/models/gemma4-31b-it-assistant","num_speculative_tokens":4}' \
  --quantization modelopt \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.7 \
  --max-model-len 4096 \
  --limit-mm-per-prompt '{"image":0,"audio":0,"video":0}'
결과
| 구성 | 코딩 (Red-Black Tree) | 설명 (Transformer) | 실측 | 평균 |
|---|---|---|---|---|
| Baseline | 6.7 tok/s | 6.2 tok/s | 6.7 tok/s | 6.5 tok/s |
| + MTP γ=4 | 21.9 tok/s | 19.8 tok/s | 14.8 tok/s | 18.8 tok/s |
| 향상 | 3.27x | 3.19x | 2.21x | 2.89x |
Dense 모델에서 MTP 효과가 압도적이다. 코딩 작업은 3.27배, 평균 2.89배. 이론적으로 Dense 모델은 검증 시 동일 가중치를 재사용하므로 MoE보다 speculative decoding 효율이 높은데, 실측에서도 정확히 그렇게 나왔다.
6.5 tok/s는 솔직히 쓰기 힘든 속도였지만, 18.8 tok/s면 충분히 대화형으로 쓸 수 있는 수준이다.
보너스: llama.cpp 비교
평소 llama.cpp로 Gemma 4를 돌리고 있으니, 동일 하드웨어에서의 비교도 기록한다. llama.cpp은 아직 Gemma 4 MTP를 지원하지 않으므로 baseline만 있다.
| 모델 | 프레임워크 | 양자화 | 평균 tok/s | 비고 |
|---|---|---|---|---|
| 26B-A4B | llama.cpp | Q8_0 | 45.4 | 가장 빠름 (MTP 없이도) |
| vLLM baseline | FP8 | 37.3 | ||
| vLLM + MTP | FP8 | 62.9 | 최종 우승 | |
| 31B Dense | llama.cpp | Q6_K_XL | 6.8 | |
| llama.cpp | NVFP4-turbo | 10.6 | ||
| vLLM baseline | NVFP4 | 6.5 | ||
| vLLM + MTP | NVFP4 | 18.8 | 최종 우승 |
흥미로운 포인트:
- 26B MoE에서 llama.cpp Q8_0 (45.4)이 vLLM FP8 baseline (37.3)보다 빠르다. llama.cpp의 MoE 최적화가 상당히 좋다. 하지만 MTP를 켜면 vLLM이 62.9로 역전.
- 31B Dense에서는 MTP가 게임 체인저다. llama.cpp NVFP4-turbo가 10.6인데, vLLM + MTP는 18.8. 거의 2배 차이.
- 한국어에서 MTP 효과가 상대적으로 낮다. 코딩은 반복 패턴이 많아 Drafter 수락률이 높고, 한국어는 토큰 다양성이 높아 수락률이 낮은 것으로 추정.
함정과 팁
1. 반드시 -it 모델과 매칭할 것
Drafter는 instruction-tuned 모델의 logit 분포에 맞춰 학습됐다. Base 모델에 연결하면 수락률이 바닥으로 떨어지면서 오히려 38% 느려진다는 보고가 있다. 이건 Google 공식 문서 어디에도 안 써있다.
2. 볼륨 마운트 실수 주의
-v /호스트/경로:/컨테이너/경로 형식을 정확히 지켜야 한다. :로 구분된 목적지 경로를 빠뜨리면 컨테이너 안에서 모델을 못 찾아 HFValidationError가 발생한다.
3. gpu-memory-utilization은 0.7이면 충분
0.85로 올리면 128GB 통합 메모리에서 너무 많이 잡아먹는다. max-model-len 4096 기준 0.7이면 넉넉하다.
4. 한국어는 MTP 효과가 상대적으로 낮다
코딩(1.98x) vs 한국어(1.38x)로 확연한 차이가 있다. Drafter의 수락률이 토큰 예측 난이도에 비례하기 때문. 영어/코드처럼 패턴이 반복되는 작업에서 MTP 효과가 극대화된다.
결론: 뭘 써야 하나
| 상황 | 추천 | 이유 |
|---|---|---|
| 26B MoE, 최대 속도 | vLLM + MTP | 62.9 tok/s, 최고 속도 |
| 26B MoE, 간편하게 | llama.cpp Q8_0 | Docker 없이 45.4 tok/s |
| 31B Dense 필수 (더 높은 품질) | vLLM + MTP | 6.5 → 18.8로 쓸만해짐 |
| 긴 컨텍스트 (64K+) | llama.cpp | 메모리 효율 우수 |
내 경우, 역사 콘텐츠 파이프라인의 대본 생성처럼 빠른 반복이 중요한 작업은 vLLM + MTP로, 긴 문서 분석이나 간단한 대화는 llama.cpp로 쓸 예정이다.
다음은
- llama.cpp에 Gemma 4 MTP 지원이 merge되면 동일 테스트 반복
- 동시 접속 (concurrency 4~8) 테스트로 aggregate throughput 확인
- 역사 콘텐츠 파이프라인에 vLLM + MTP 연결해서 실제 대본 생성 시간 비교
- RedHat FP8 vs NVFP4 비교 (31B에서 FP8이 더 빠른지 확인)
테스트 일시: 2026-05-06 | 하드웨어: NVIDIA DGX Spark GB10 (128GB) | vLLM 0.20.2rc1 preview | Gemma 4 MTP Drafter (2026-05-05 공개)