Krea 2 Turbo on DGX Spark: 생성 시간을 40초에서 16초로 단축한 최적화 기록
⚠️ 먼저 고백하자면 — 꽤 오래 헤맸다
ComfyUI에서 Krea 2가 동작은 하는데 너무 느렸다. BF16 체크포인트 하나 로딩하는 데만 수십 초, 워크플로우 실행까지 포함하면 이미지 한 장에 40초가량 소요되었다. "Blackwell GB10에서 이게 최선일까?"라는 의문이 들어 최적화를 시작했다. 여러 시행착오 끝에 순정 ComfyUI(v0.26.0)와 7개 노드만으로 구성한 단순한 워크플로우를 사용해 16초 대까지 단축했으며, NVFP4(4-bit 부동소수점) 양자화 모델도 정상 동작함을 확인했다. 이 글은 그 과정을 기록한다.
▲ Krea 2 Turbo가 생성한 우주 성운 이미지 — 8 step, CFG=1.0, 1024×1024
1. Krea 2 개요
Krea 2는 Comfy-Org에서 공개한 고품질 이미지 생성 모델이다. 두 가지 추론 모드를 제공한다:
- Turbo: 8-step distilled checkpoint. 신속한 생성에 최적화되어 있다.
- Raw: 52-step undistilled. LoRA 학습이나 정밀한 제어가 필요할 때 사용한다.
DGX Spark GB10에 탑재된 Blackwell GPU는 NVFP4(NVIDIA 4-bit Floating Point)를 네이티브로 지원한다. 동일 모델을 BF16(26.3GB) 대비 약 1/3 크기인 7.67GB로 양자화할 수 있으며, 추론 속도도 더 빠르다.
2. 설치된 모델 구성
| 파일 | 용량 | 비고 |
|---|---|---|
| krea2_turbo_nvfp4.safetensors | 7.67 GB | ✅ 현재 워크플로우 사용 — Blackwell 최적 |
| krea2_turbo_bf16.safetensors | 26.3 GB | 기본 (무난) |
| qwen3vl_4b_fp8_scaled.safetensors | 5.2 GB | FP8 텍스트 인코더 |
| qwen3vl_4b_int8.safetensors | 4.9 GB | INT8 텍스트 인코더 (구형) |
| qwen_image_vae.safetensors | 254 MB | VAE (필수) |
3. 최적화 과정
3.1. Phase 1: 5-노드 워크플로우 (약 40초)
초기 설정은 CheckpointLoaderSimple을 사용하는 5개 노드 구조였다. ComfyUI ops.py와 model_detection.py에 수동 패치를 적용해야 했고, CLIPLoader의 type을 krea2가 아닌 stable_diffusion으로 설정하는 바람에 호환성 문제도 겪었다. INT8 텍스트 인코더를 강제로 지정해야만 로딩이 되는 등, 우회 조치가 여러 군데 필요했다. 정상 동작은 했지만 생성 시간이 40초가량으로 만족스럽지 않았다.
3.2. Phase 2: UNETLoader + FP8 TE (약 16초)
ComfyUI v0.26.0부터 Krea 2가 공식적으로 네이티브 지원된다는 사실을 알게 되었다. 더 이상 ops.py나 model_detection.py를 건드릴 필요가 전혀 없었다. CheckpointLoaderSimple 대신 UNETLoader를 사용하고, CLIPLoader type을 krea2로 설정하는 것만으로 정상 구동되었다. 더불어 FP8 버전의 텍스트 인코더(qwen3vl_4b_fp8_scaled)도 문제없이 동작했다. 부정 프롬프트 처리는 ConditioningZeroOut 하나로 해결되어 노드 수가 오히려 줄었다.
▲ Krea 2 Turbo 생성 결과 — 판타지 일러스트, 720×1280, 8 step, 약 16초 소요
3.3. Phase 3: NVFP4 도입
Blackwell GPU에서 NVFP4를 활용하면 이론상 더 빠르다. krea2_turbo_nvfp4.safetensors(7.67GB)는 BF16(26.3GB) 대비 용량이 1/3이며, Blackwell의 연산 유닛이 이 포맷을 직접 처리할 수 있어 속도 이점이 있다. 실제 측정 결과 첫 생성(모델 로딩 포함) 22초, 이후 16초로 BF16과 유사한 속도를 보였다. 용량이 작아지면서 모델 전환(스왑)이 빠르다는 장점이 있다.
▲ NVFP4 모델로 생성한 풍경 — 1024×1024, 첫 로딩 포함 22초
4. 최종 워크플로우
총 7개 노드로 구성되어 있다. 워크플로우 파일은 [local path]에 위치한다.
UNETLoader (krea2_turbo_nvfp4)
    ↓
KSampler (er_sde, CFG=1.0, steps=8)
    ← CLIPTextEncode(positive)
        ← CLIPLoader(type=krea2, FP8 TE)
    ↓
VAEDecode ← VAELoader (qwen_image_vae)
    ↓
PreviewImage
각 노드별 주요 설정:
- UNETLoader: unet_name = krea2_turbo_nvfp4.safetensors, weight_dtype = default
- CLIPLoader: clip_name = qwen3vl_4b_fp8_scaled.safetensors, type = krea2 (필수)
- VAELoader: vae_name = qwen_image_vae.safetensors
- KSampler: steps = 8, cfg = 1.0, sampler_name = er_sde
- ConditioningZeroOut: positive에서 negative 파생 (별도 CLIPTextEncode 불필요)
▲ 사이버펑크 시티 — Turbo 8-step, 720×1280, 16초
5. 성능 측정
| 구분 | 모델 | 생성 시간 | 비고 |
|---|---|---|---|
| 이전 (BF16) | krea2_turbo_bf16 | ~40초 | 패치 적용, INT8 TE 강제 |
| 현재 (NVFP4, 첫 생성) | krea2_turbo_nvfp4 | ~22초 | 모델 로딩 포함 |
| 현재 (NVFP4, 두 번째 이후) | krea2_turbo_nvfp4 | ~16초 | 캐시 히트 |
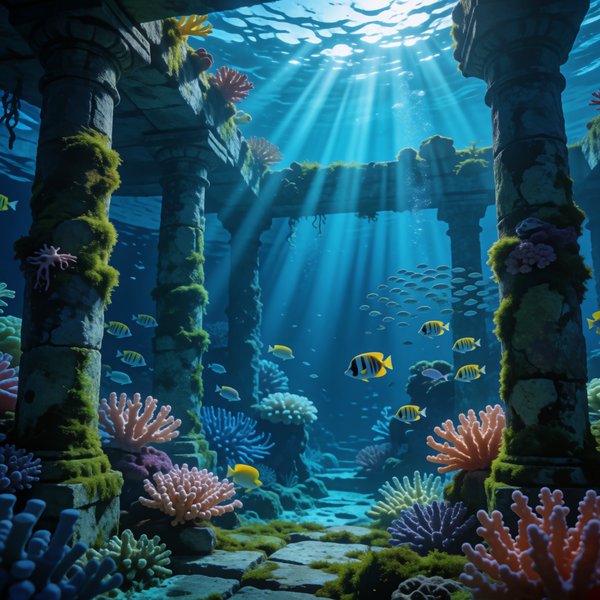
▲ 수중 유적 — 1024×1024, 18초. Turbo 모드에서도 디테일이 살아 있다
6. 알게된 점 (시행착오 기록)
- CLIPLoader type은 반드시 "krea2" — stable_diffusion으로 설정하면 CLIP 로딩은 되지만 컨디셔닝이 정상적으로 동작하지 않는다.
- Krea2ImageNode는 클라우드 API 전용이다 — 이 노드는 is_api_node=True 속성을 가지며, Krea 클라우드 서버로 요청을 전송한다. 로컬 모델 추론과 전혀 무관한 노드이므로 혼동하지 말아야 한다.
- CFG=0.0을 사용하면 프롬프트가 완전히 무시된다 — Turbo 모드의 권장 CFG는 1.0이다. CFG를 0으로 설정하면 모델이 프롬프트를 전혀 반영하지 않고 학습 데이터의 분포에서 샘플링하므로, 매번 유사한 무작위 결과만 생성된다.
- VAE는 반드시 qwen_image_vae.safetensors만 사용해야 한다 — zImageTurbo_vae 또는 다른 VAE를 연결하면 VAEDecode 단계에서 shape mismatch가 발생하거나 조용히 실패한다.
- 패치는 전혀 필요 없다 — ComfyUI v0.26.0 이상이 Krea 2를 공식 지원한다. ops.py나 model_detection.py를 수정할 이유가 없다.
- NVFP4가 BF16보다 항상 빠른 것은 아니다 — Blackwell이 NVFP4를 네이티브 지원하기는 하지만, 실제 추론 속도는 메모리 대역폭과 커널 최적화에 의존한다. 현재 측정 결과 BF16과 NVFP4의 생성 속도는 유사했다. 하지만 모델 용량이 작아 로딩/전환이 빠르다는 실질적인 이점이 있다.
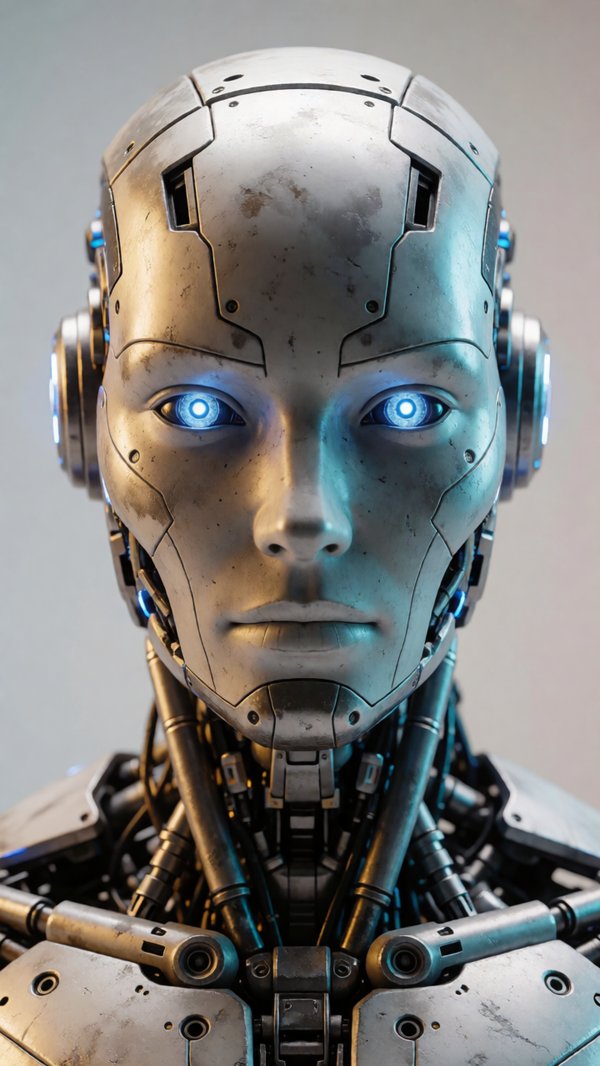
▲ NVFP4 모델 — 로봇 포트레이트, 720×1280, 16초
7. 실행 방법
서버 실행:
cd [local path] && bash run_dgx_spark.sh
API 호출 (프롬프트만 변경):
curl -s http://[internal endpoint]/prompt -H "Content-Type: application/json" -d "$(cat [local path] | sed 's/원본_프롬프트/새로운_프롬프트/g')"
또는 Python API 클라이언트로 워크플로우 JSON을 읽어서 prompt 필드만 교체한 뒤 POST /prompt로 전송하면 된다.
8. 맺음말
DGX Spark(Grace ARM + Blackwell)에서 Krea 2 Turbo는 실사용에 충분한 수준이다. 16초면 720×1280 이미지 한 장을 생성할 수 있다. NVFP4 모델의 추가 이점(용량 감소, 전환 속도 향상)도 확인했다. 무엇보다 ComfyUI가 Krea 2를 공식 지원하면서 이전에 필요했던 각종 패치와 우회 설정이 모두 사라져 유지보수 부담이 크게 줄었다. Krea 2 기반 이미지 생성 파이프라인은 현재 이 워크플로우로 고정하여 운영 중이다.
테스트 환경: NVIDIA DGX Spark GB10 (Grace ARM 20-core + Blackwell GPU), ComfyUI v0.26.0, PyTorch 2.11, Ubuntu 24.04 ARM64. 측정은 8 step Turbo 모드, er_sde sampler, CFG=1.0 기준.