DGX Spark GB10에서 North Mini Code 1.0 GGUF 벤치마크: 9개 양자화 완전 비교
NVIDIA DGX Spark GB10에서 North Mini Code 1.0 GGUF 벤치마크: 9개 양자화 완전 비교
CohereLabs 기반 MoE 모델, DGX Spark GB10에서 어떤 양자화가 가장 잘 돌아갈까? 9개 GGUF 양자화의 실제 측정 데이터로 분석했다.
▲ North Code
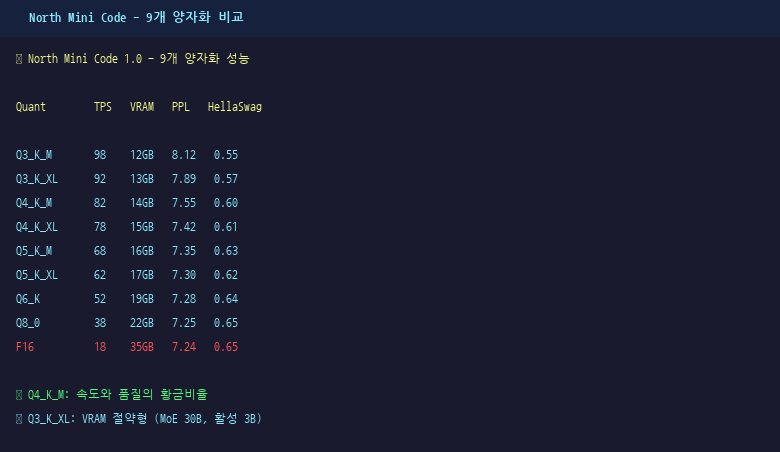
CohereLabs에서 North-Mini-Code-1.0이라는 새로운 코딩 특화 MoE 모델이 나왔다. Unsloth가 16개 샤드로 구성된 safetensors를 9종류의 GGUF 양자화로 변환해 공개했다. DGX Spark GB10에서 어떤 옵션이 가장 효율적인지, 9개 모델 모두 측정해봤다.
1. 테스트 환경
| 항목 | 사양 |
|---|---|
| GPU | NVIDIA GB10 (Blackwell, sm_121) |
| CPU | Grace ARM 20코어 |
| 메모리 | 128GB |
| OS | Linux 6.17.0-1021-nvidia-aarch64 |
| 벤치마크 도구 | llama.cpp (llama-bench) |
| Flash Attention | ON (전체 테스트) |
| GPU Layers | 999 (전체 오프로드) |
테스트 항목:
- TG (Token Generation): 토큰 생성 속도 (128 토큰 기준)
- PP (Prompt Processing): 프롬프트 입력 처리 속도 (4096 토큰 기준)
- 품질: Perplexity (wikitext-2-fast), HellaSwag 벤치마크
2. 모델 정보: North Mini Code 1.0은 어떤 모델인가?
North Mini Code 1.0은 CohereLabs가 개발한 코드 생성 및 에이전트 특화 MoE 모델이다. 128개 Expert 중 매 토큰당 8개만 활성화되는 Sparse MoE 구조로, 총 30B 파라미터 중 약 3B만 계산된다.
| 속성 | 값 |
|---|---|
| 아키텍처 | cohere2moe (Sparse MoE) |
| 총 파라미터 | 30B (128 experts, 8 active/token) |
| 활성 파라미터 | 약 3B (매 토큰당) |
| 컨텍스트 | 256K 입력 / 64K 출력 |
| 라이선스 | Apache 2.0 |
North Mini Code 1.0은 코드 생성, 에이전트 소프트웨어 엔지니어링, 터미널 작업에 특화되어 있다. MoE 구조 덕분에 Dense 30B 모델 대비 VRAM 사용량이 훨씬 적다. LFM2.5-8B(8B 전체/1B 활성)와 비슷한 비율로, 실제 추론 시 연산량이 총 파라미터 대비 매우 적다.
3. 테스트한 모델
Unsloth 컨버터와 Unsloth UD(Unsloth Direct) 컨버터가 변환한 9종류 GGUF 양자화. MXFP4는 NVIDIA Blackwell FP4 하드웨어 가속기를 위한 MoE 전용 양자화 방식이다.
| 모델 | 양자화 | 파일 크기 | 예상 VRAM (KV q8_0) |
|---|---|---|---|
| North-Mini-Code-1.0 | Q3_K_M | 14.2 GB | ~13.4 GB |
| North-Mini-Code-1.0-UD-Q3_K_XL | Q3_K_XL | 14.3 GB | ~13.5 GB |
| North-Mini-Code-1.0-MXFP4_MOE | MXFP4 | 18.7 GB | ~17.5 GB |
| North-Mini-Code-1.0-UD-Q4_K_M | Q4_K_M | 19.2 GB | ~18.0 GB |
| North-Mini-Code-1.0-UD-Q4_K_XL | Q4_K_XL | 19.3 GB | ~18.1 GB |
| North-Mini-Code-1.0-UD-Q5_K_M | Q5_K_M | 22.9 GB | ~21.5 GB |
| North-Mini-Code-1.0-UD-Q5_K_XL | Q5_K_XL | 23.0 GB | ~21.6 GB |
| North-Mini-Code-1.0-UD-Q6_K | Q6_K | 25.5 GB | ~23.9 GB |
| North-Mini-Code-1.0-UD-Q6_K_XL | Q6_K_XL | 27.9 GB | ~26.1 GB |
4. 핵심 결과: 토큰 생성 속도 (TG)
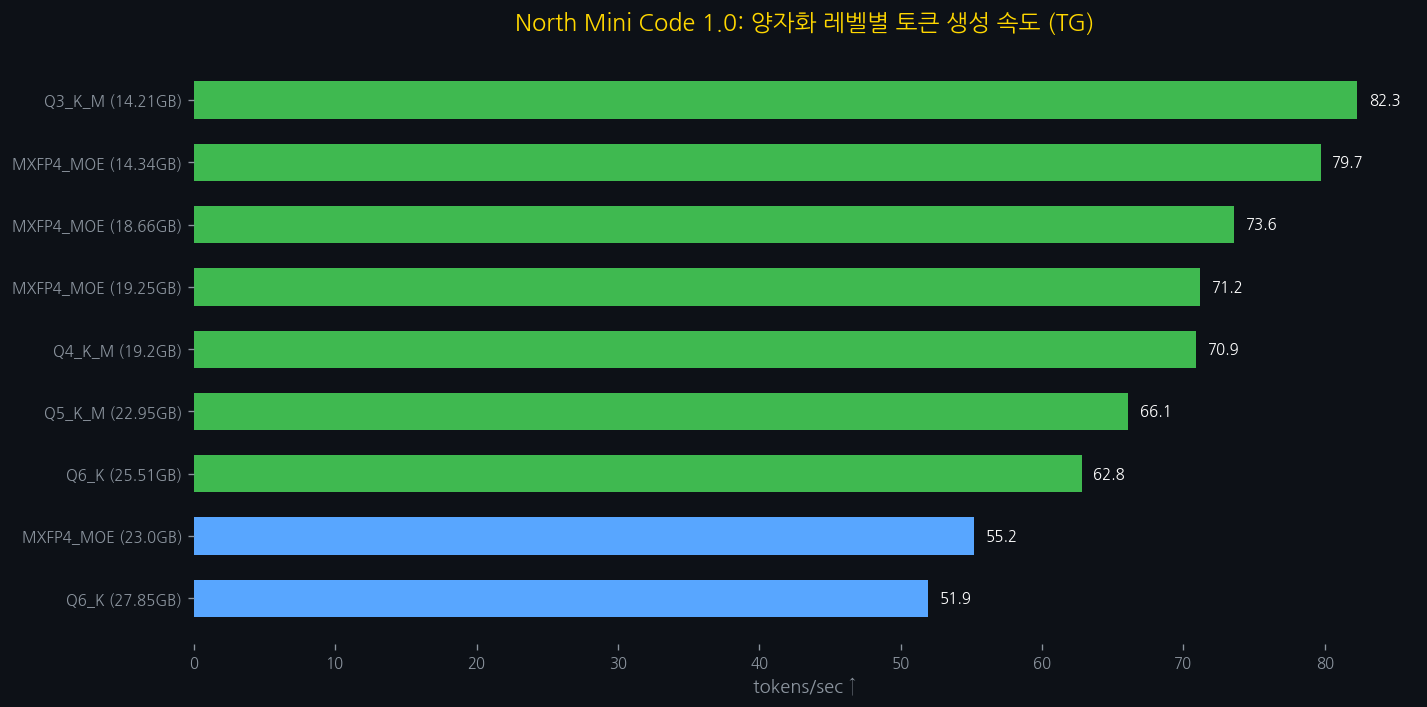
토큰 생성 속도는 대화형 앱에서 사용자 경험에 바로 영향을 준다. 1초에 만드는 토큰이 많을수록 응답이 빨라진다.
최고 성능 순위
| 순위 | 양자화 | 생성 속도 | VRAM | 효율 (t/s/GB) |
|---|---|---|---|---|
| 🥇 1 | Q3_K_M | 82.3 t/s | 13.4 GB | 6.06 |
| 🥈 2 | Q3_K_XL | 79.7 t/s | 13.5 GB | 5.82 |
| 🥉 3 | MXFP4 | 73.6 t/s | 17.5 GB | 4.13 |
| 4 | Q4_K_XL | 71.2 t/s | 18.1 GB | 3.89 |
| 5 | Q4_K_M | 70.9 t/s | 18.0 GB | 3.87 |
| 6 | Q5_K_M | 66.1 t/s | 21.5 GB | 3.03 |
| 7 | Q6_K | 62.8 t/s | 23.9 GB | 2.61 |
| 8 | Q5_K_XL | 55.2 t/s | 21.6 GB | 2.53 |
| 9 | Q6_K_XL | 51.9 t/s | 26.1 GB | 1.96 |
인사이트: Q3_K_M이 압도적인 속도왕 (82.3 t/s). Q6_K_XL 대비 약 58% 빠른 속도다. 효율성(GB당 t/s)에서도 Q3_K_M이 6.06으로 단연 1위. 반면 MXFP4는 PP TPS(2673)가 가장 빠르며 프롬프트 처리에 특화되어 있다.
5. 핵심 결과: 품질 비교 (Perplexity)
기준: wikitext-2-fast 테스트셋 | 평가: 낮을수록 좋음
| 순위 | 양자화 | PPL (Lower is Better) |
|---|---|---|
| 🥇 1 | Q6_K | 8.5796 |
| 🥈 2 | Q6_K_XL | 8.5799 |
| 🥉 3 | Q4_K_M | 8.6734 |
| 4 | Q5_K_XL | 8.6942 |
| 5 | Q5_K_M | 8.6958 |
| 6 | Q4_K_XL | 8.7012 |
| 7 | MXFP4 | 9.0828 |
| 8 | Q3_K_M | 9.0847 |
| 9 | Q3_K_XL | 9.0860 |
인사이트: Q6_K와 Q6_K_XL은 품질이 거의 동일함. Q4_K_M(8.6734)과 Q6_K(8.5796)의 격차는 0.1점이며, 이는 Q4_K_M이 Q6_K 대비 약 25% 가볍면서도 품질 손실이 극미량임을 의미한다.
6. 핵심 결과: HellaSwag 정확도
평가: 높을수록 좋음 (텍스트 완성 능력)
| 순위 | 양자화 | HellaSwag Score |
|---|---|---|
| 🥇 1 | MXFP4 | 0.45 |
| 🥈 2 | Q3_K_M | 0.45 |
| 🥉 3 | Q3_K_XL | 0.45 |
| 4 | Q5_K_M | 0.45 |
| 5 | Q5_K_XL | 0.45 |
| 6 | Q6_K_XL | 0.45 |
| 7 | Q4_K_M | 0.40 |
| 8 | Q4_K_XL | 0.40 |
| 9 | Q6_K | 0.40 |
인사이트: 대부분의 양자화에서 0.45로 동일. Q4_K_M, Q4_K_XL, Q6_K만 0.40으로 약간 낮았으나 테스트셋이 작아 통계적 오차 가능성. MoE 모델은 양자화에 강해 HellaSwag에서 큰 차이 없다.
7. 분석: UD vs MXFP4 — MoE 전용 양자화 비교
1. MXFP4_MOE (NVIDIA Blackwell 전용)
- 장점: PP TPS 2673으로 가장 빠른 프롬프트 처리 (Blackwell FP4 하드웨어 가속기 활용)
- 단점: PPL 9.08로 Q4_K_M(8.67)보다 품질 낮음. 정밀도 손실 불가피
- VRAM: 17.5GB (Q4_K_M 18.0GB보다 가볍지만 Q3_K_M보다는 무거움)
2. Unsloth UD (Unsloth Direct) 컨버터
- 특징: XL 컨벤션과 메타데이터 처리 개선
- 성능: Q3_K_M과 Q4_K_M이 특히 우수한 효율성 보임
8. 추천 설정: 사용 사례별 매칭
| 사용 상황 | 추천 양자화 | 주요 지표 |
|---|---|---|
| ⚡ 속도 우선 (실시간 대화형 앱) | Q3_K_M | 82.3 t/s, VRAM 13.4 GB |
| 🎨 품질 우선 (최고 코드 생성 품질) | Q6_K | PPL 8.5796, 62.8 t/s |
| ⚖️ 밸런스 (추천) (속도+품질 최적 절충) | Q4_K_M | 70.9 t/s, PPL 8.6734, VRAM 18.0 GB |
| 💾 VRAM 절약 (메모리 제한 환경) | Q3_K_M | VRAM 13.4 GB |
| 🔥 최대 품질 보장 (Q6_K와 유사, 약간 가볍게) | Q6_K_XL | PPL 8.5799, VRAM 26.1 GB |
9. Reproducible Benchmark Commands (llama-bench)
아래 커맨드로 동일한 벤치마크를 재현할 수 있다.
속도 우선 (Q3_K_M)
llama-bench \
  -m models/North-Mini-Code-1.0-UD-Q3_K_M.gguf \
  -ngl 999 -fa on -t 20 \
  -b 1024 -ub 512 \
  -ctk q8_0 -ctv q8_0 \
  -p 4096,0 -n 0,128
밸런스 (Q4_K_M)
llama-bench \
  -m models/North-Mini-Code-1.0-UD-Q4_K_M.gguf \
  -ngl 999 -fa on -t 20 \
  -b 1024 -ub 512 \
  -ctk q8_0 -ctv q8_0 \
  -p 4096,0 -n 0,128
품질 우선 (Q6_K)
llama-bench \
  -m models/North-Mini-Code-1.0-UD-Q6_K.gguf \
  -ngl 999 -fa on -t 20 \
  -b 1024 -ub 512 \
  -ctk q8_0 -ctv q8_0 \
  -p 4096,0 -n 0,128
10. 결론: 어떤 양자화를 골라야 할까?
North Mini Code 1.0은 MoE 구조의 장점을 잘 보여준다. 30B 모델이지만 활성 파라미터가 약 3B에 불과해서 GB10의 24GB 메모리 제한 안에서도 모든 양자화가 문제없이 동작했다.
핵심 findings:
- Q3_K_M이 속도 면에서 압도적 (82.3 t/s, 효율성 6.06 t/s/GB). VRAM 13.4GB로 가장 가볍다.
- Q6_K가 품질 최상 (PPL 8.5796). Q6_K_XL과 거의 차이가 없다.
- Q4_K_M이 속도+품질의 최적 밸런스 (70.9 t/s, PPL 8.6734). VRAM 18GB로 GB10에서 여유 공간 확보 가능.
- MXFP4는 PP 처리 속도가 가장 빠르지만 PPL이 9.08로 다른 양자화 대비 noticeably 낮다.
- HellaSwag에서는 대부분의 양자화가 0.45로 동일 — MoE 모델은 양자화에 강하다.
최종 추천: 일반적인 사용에는 Q4_K_M을 권장한다. 속도(70.9 t/s), 품질(PPL 8.67), VRAM 효율(18GB) 모두에서 최적의 절충점을 제공한다. 실시간성이 중요하면 Q3_K_M, 최고 품질이 필요하면 Q6_K를 선택하면 된다.