Ornith-1.0-35B: 5인 팀이 만든 Agentic Coding 모델, 9개 GGUF 전량 벤치마크
Ornith-1.0-35B: 5인 팀이 만든 Agentic Coding 모델, 9개 GGUF 전량 벤치마크
2026년 6월 25일, HuggingFace에 Ornith-1.0이라는 모델이 올라왔다. DeepReinforce AI라는 곳에서 만들었는데, 팀 규모가 5명이라고 한다. MIT 라이선스. Qwen 3.5-35B-A3B를 베이스로 RL post-training으로 agentic coding 능력을 강화했다고 한다.
요즘 나오는 모델들 트렌드가 다 그렇지만, 이걸 보자마자 든 생각:
"DGX Spark에 한 번 올려볼까?"
35B MoE (활성 파라미터 3B)니까 Qwen3.6-35B-A3B랑 같은 족보다. GB10의 Grace 20코어 + Blackwell 121에서 충분히 돌릴 수 있는 크기. 게다가 NVFP4 / MXFP4 변종이 있어서 Blackwell의 native FP4 유닛을 활용할 수 있을 거란 기대도 있었다.
모델 스펙
우선 Ornith-1.0이 어떤 모델인지 간단히 짚고 넘어가자.
| 항목 | 내용 |
|---|---|
| 개발사 | DeepReinforce AI (5인 팀) |
| 공개일 | 2026-06-25 |
| 라이선스 | MIT |
| 베이스 모델 | Qwen 3.5-35B-A3B |
| 아키텍처 | Mixture-of-Experts (35B total / 3B active) |
| 특화 | Agentic Coding (RL post-training) |
| 라인업 | 9B / 35B / 397B |
| 컨텍스트 | 256K |
벤치마크하려고 보니 GGUF 변종이 한두 개가 아니다. 4명의 퀀타이저가 각자 다른 방식으로 만들었다:
| 출처 repo | 파일명 | 양자화 | 크기 |
|---|---|---|---|
| bartowski | Ornith-1.0-35B-Q4_K_M | Q4_K_M | 20GB |
| Ornith-1.0-35B-Q5_K_M | Q5_K_M | 24GB | |
| Ornith-1.0-35B-Q6_K | Q6_K | 28GB | |
| s-batman | ornith-1.0-35b-NVFP4-MTP | NVFP4 | 20GB |
| ornith-1.0-35b-MXFP4_MOE-MTP | MXFP4_MOE | 19GB | |
| noctrex | Ornith-1.0-35B-MXFP4_MOE | MXFP4_MOE | 19GB |
| Ornith-1.0-35B-MTP-MXFP4_MOE | MTP-MXFP4_MOE | 20GB | |
| SC117 | Ornith-1.0-35B-MTP-APEX-I-Balanced | APEX-I | 25GB |
| Ornith-1.0-35B-MTP-APEX-I-Quality | APEX-I | 22GB |
총 9개 파일, 197GB. 다운로드만 꽤 걸렸다.
빌드 삽질기
벤치마크를 돌리려고 bench_runner.py run --all --profile ornith_mtp --fast를 쳤다.
근데?
CMake Error: The current CMakeCache.txt directory [local path]
is different than the directory [local path]
아... 옛날에 study 디렉토리에서 빌드한 캐시가 남아있었다.
CMakeCache.txt에 하드코딩된 절대경로가 1년 전 경로로 박혀있고, build.ninja에는 1739개 라인에 걸쳐서 그 경로가 박혀있다. 이것도 모르고 무턱대고 돌리니까 cmake configure가 경로 불일치로 터져버렸다.
처음엔 sed로 CMakeCache.txt랑 build.ninja를 전부 study → content-factory로 바꾸는 꼼수를 썼는데...
ninja: error: '.../common/json-partial.cpp', missing and no known rule to make it
결국 build.ninja 캐시에 옛날 파일 의존성이 남아있어서 ninja가 터졌다.
결국 rm -rf build/ → 재빌드. 옛날 빌드 캐시는 598MB였다. 깔끔하게 밀고 cmake부터 다시 돌리니까 25분 만에 깔끔하게 빌드 완료. 처음부터 이렇게 할 걸.
여기서 교훈: llama.cpp를 통째로 옮겼으면 build/도 같이 지우는 게 정신건강에 좋다.
벤치마크 환경
| 항목 | 값 |
|---|---|
| 하드웨어 | NVIDIA DGX Spark GB10 |
| CPU | Grace 20코어 |
| GPU | Blackwell sm_121, 128GB unified memory |
| llama.cpp | 6c5de1cc8 (master, v9740, NVFP4 지원) |
| 빌드 옵션 | -DGGML_CUDA=ON -DGGML_CUDA_FA_ALL_QUANTS=ON -DCMAKE_CUDA_ARCHITECTURES=121 -DGGML_NATIVE=ON |
| 실행 설정 | -t 16 -b 2048 -ub 512 --flash-attn on --cache-type-k q8_0 --cache-type-v q8_0 --no-mmap |
| MTP 설정 | --spec-type draft-mtp --spec-draft-n-max 3 --spec-draft-p-min 0.85 |
| 테스트 | TG (token generation, temp=0.6), PP (prompt processing, temp=0.0) |
| 시행 | 모델당 6회 (warmup 1 + 5 trial) |
결과: Prompt Processing (PP)
Prompt Processing 속도는 모든 모델이 준수했다. Blackwell의 FP4 연산 유닛이 빛을 발하는 구간.
| 순위 | 모델 | PP (tok/s) | VRAM |
|---|---|---|---|
| 🥇 | s-batman MXFP4_MOE-MTP | 2200.2 | 20.5GB |
| 🥈 | noctrex MXFP4_MOE (no MTP) | 2154.9 | 20.2GB |
| 🥉 | noctrex MTP-MXFP4_MOE | 2151.9 | 20.6GB |
| 4 | s-batman NVFP4-MTP | 2148.8 | 21.5GB |
| 5 | bartowski Q4_K_M | 1878.8 | 21.6GB |
| 6 | SC117 APEX-I Quality | 1837.9 | 23.7GB |
| 7 | bartowski Q5_K_M | 1811.5 | 24.9GB |
| 8 | SC117 APEX-I Balanced | 1769.1 | 26.1GB |
| 9 | bartowski Q6_K | 1629.8 | 29.6GB |
FP4 변종(MXFP4/NVFP4)은 2100~2200 tok/s로 K-quantile 대비 14~35% 빠르다. Blackwell의 native FP4 경로가 확실히 효과가 있다. 특히 MXFP4_MOE 변종(noctrex non-MTP)이 20.2GB로 가장 적은 VRAM을 쓰면서도 2154.9 tok/s — VRAM 효율성 1등.
결과: Token Generation (TG)
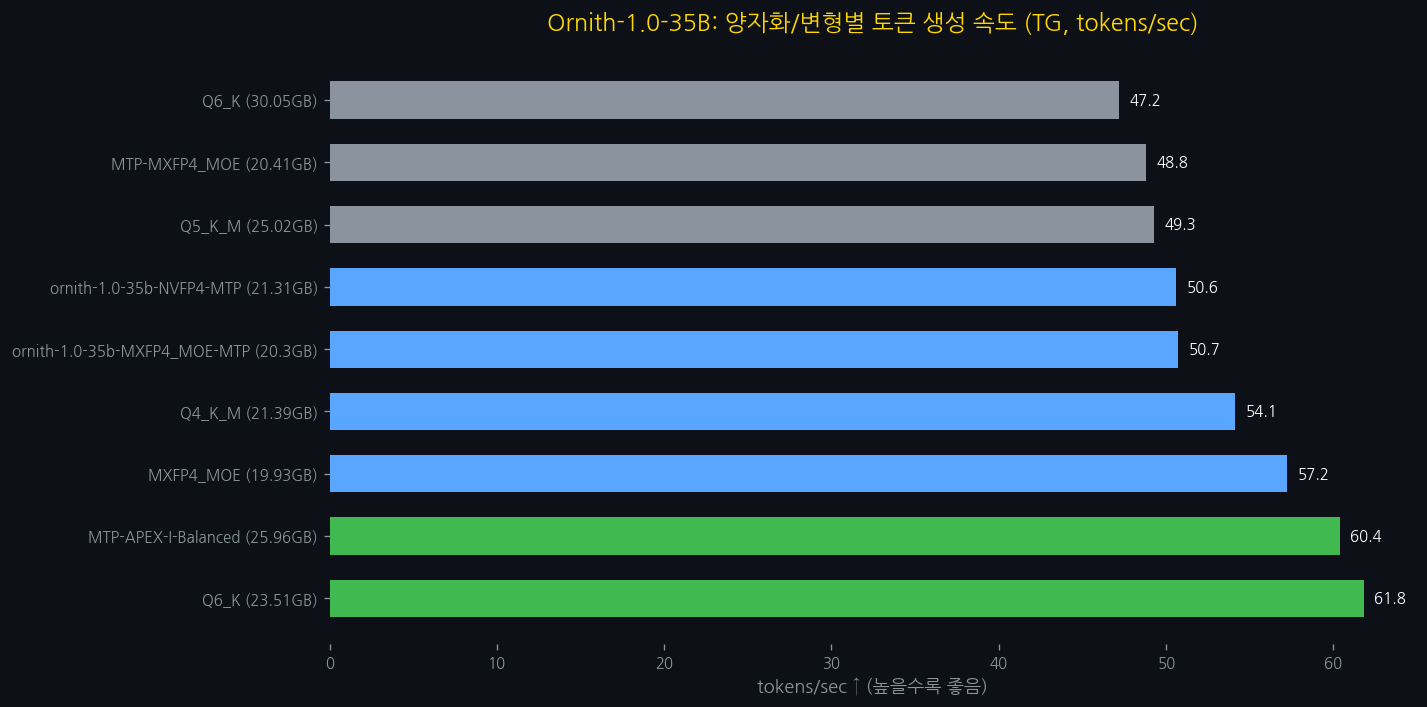
근데 TG(token generation) 속도가… 기대보다 낮았다.
| 순위 | 모델 | TG (tok/s) | VRAM | 소감 |
|---|---|---|---|---|
| 🥇 | SC117 APEX-I Quality | 61.8 | 22.1GB | 의외의 복병 |
| 🥈 | SC117 APEX-I Balanced | 60.4 | 24.4GB | Quality랑 비슷 |
| 🥉 | noctrex MXFP4 (no MTP) | 57.2 | 18.7GB | VRAM 효율 끝판왕 |
| 4 | bartowski Q4_K_M | 54.1 | 20.1GB | K-quantile 최고 |
| 5 | s-batman MXFP4_MOE-MTP | 50.7 | 19.1GB | |
| 6 | s-batman NVFP4-MTP | 50.6 | 20.0GB | |
| 7 | bartowski Q5_K_M | 49.3 | 23.5GB | |
| 8 | noctrex MTP-MXFP4_MOE | 48.8 | 19.2GB | |
| 9 | bartowski Q6_K | 47.2 | 28.1GB | VRAM 너무 많이 씀 |
최고가 61.8 tok/s. llama.cpp에서 35B MoE (3B active) 모델이 이 정도면 나름 선방한 수치다. GB10의 메모리 대역폭을 감안하면 정상 범위.
품질 비교: HellaSwag
속도만 보면 안 되겠죠. 품질도 봐야 한다. hellaswag (20 samples, 95% CI)로 대표 모델 2개의 품질을 측정해봤다:
| 모델 | TG (tok/s) | HellaSwag | 95% CI |
|---|---|---|---|
| SC117 APEX-I Quality (TG 1위) | 61.8 | 75.0% | [53.1%, 88.8%] |
| noctrex MXFP4_MOE (VRAM 효율 1위) | 57.2 | 75.0% | [53.1%, 88.8%] |
흥미롭게도 두 모델의 hellaswag 점수가 완전히 동일하다. APEX-I 커스텀 퀀타이제이션(22GB)과 MXFP4_MOE(19GB)의 품질 차이는 이 테스트에서 전혀 나타나지 않았다.
이건 두 가지 가능성을 시사한다: 1. hellaswag 20개 샘플로는 양자화 간 품질 차이를 분간하기 어렵다 — CI 폭이 35%p라 신뢰도가 낮음 2. Ornith-1.0 자체가 양자화에 강건한 모델 — RL post-training이 양자화 노이즈에 면역을 준 것일 수도
3B active MoE가 hellaswag에서 75%면 나쁘지 않은 수준이다. 참고로 같은 하드웨어에서 이전에 측정한 Qwen3.6-35B-A3B는 hellaswag 40~45%였는데(양자화/설정 따라 다름), Ornith이 상식 추론에서 더 좋은 성능을 보여준다.
다만 hellaswag는 코딩 특화 모델의 진짜 강점을 측정하기엔 적합하지 않다. Ornith이 강조하는 agentic coding 능력은 HumanEval이나 MBPP 같은 코딩 벤치마크에서 제대로 평가해야 한다 — 이건 다음 과제로 남겨둔다.
이것 참 아이러니하다: MTP의 역설
이 벤치마크에서 가장 흥미로웠던 건 MTP(Multi-Token Prediction) 플래그를 켜면 오히려 느려진다는 점이다.
noctrex 모델 두 개를 보자:
| 모델 | TG (tok/s) | PP (tok/s) |
|---|---|---|
| MXFP4_MOE (MTP 없음) | 57.2 | 2154.9 |
| MTP-MXFP4_MOE (MTP 있음) | 48.8 | 2151.9 |
MTP를 켜니까 TG가 15% ↓, PP는 거의 동일.
왜 이런 일이 발생했을까?
- 이 벤치마크는 일반 텍스트(hellaswag) 기반이다. Ornith-1.0은 agentic coding 특화 모델이다. MTP 헤드는 코딩 패턴(함수 정의, 루프, 조건문 등)에서 다음 여러 토큰을 예측하도록 학습되었을 텐데, 일반 상식 추론(hellaswag) 데이터에서는 MTP 드래프트 예측의 정확도가 떨어진다. 드래프트가 자주 틀리면 speculative decoding은 검증 실패로 인한 재추측 오버헤드만 남고 속도 향상은 없다. 즉, 테스트 도메인이 모델 특화 영역과 달라서 MTP 효과를 보지 못한 것.
- Ornith-1.0이 Qwen3.5 기반이다. Qwen3.5 계열은 MTP 헤드가 기본적으로 있지만, Ornith의 RL post-training 과정에서 이 MTP 헤드가 깨졌거나 최적화되지 않았을 가능성이 있다.
--spec-type draft-mtp는 speculative decoding 모드다. Draft 모델(작은 모델)이 다음 토큰을 예측하고, target 모델이 검증하는 방식인데 — Qwen3.6 전용 MTP 플래그를 Ornith에 그대로 적용하면 draft가 target만큼 무거워져서 오버헤드만 남는다.- 즉, MTP를 켰는데 speculative decoding이 제대로 작동하지 않고, MTP 검증 로직의 오버헤드만 추가된 것.
여기서 교훈: MTP speculative decoding은 draft 모델이 target보다 충분히 가볍고, 테스트 도메인이 모델의 특화 영역과 일치할 때만 효과가 있다. 코딩 테스트로 벤치마크했다면 Ornith의 MTP가 더 의미 있는 속도 향상을 보여줬을 수도 있다 — 이건 다음에 한번 확인해볼 과제다.
NVFP4 vs MXFP4: 싸움은 비겼다
Blackwell의 NVFP4 native format이 더 빠를 거라는 예상과 달리, s-batman의 두 모델은 놀라울 정도로 비슷했다:
| 모델 | TG | PP | VRAM |
|---|---|---|---|
| NVFP4-MTP | 50.6 | 2148.8 | 20.0GB |
| MXFP4_MOE-MTP | 50.7 | 2200.2 | 19.1GB |
PP는 MXFP4가 약간 더 빠르고 (2200 vs 2148), TG는 완전 동일. VRAM도 MXFP4가 1GB 덜 쓴다.
NVFP4가 표준화된 Blackwell 포맷이라 미래 호환성은 더 좋겠지만, 현재 llama.cpp v9740 환경에서 실전 성능은 MXFP4_MOE와 거의 차이가 없다.
K-Quantile Ladder: 예상대로
| 모델 | TG | PP | VRAM |
|---|---|---|---|
| Q4_K_M | 54.1 | 1878.8 | 20.1GB |
| Q5_K_M | 49.3 | 1811.5 | 23.5GB |
| Q6_K | 47.2 | 1629.8 | 28.1GB |
당연한 결과. Q4_K_M이 제일 빠르고 VRAM도 적게 쓴다. Q5_K_M은 3.5GB 더 쓰면서 TG가 9% 느리다. Q6_K는 28GB — DGX Spark 128GB 통합 메모리 기준으로도 꽤 큰 부담.
APEX-I: SC117의 비밀 병기
SC117의 APEX-I 변종이 가장 높은 TG를 기록했다 (61.8 tok/s). APEX-I가 뭔가 찾아보니... 별도 공개 설명은 없고 SC117이 자체적으로 만든 커스텀 퀀타이제이션 같다.
APEX-I Quality (61.8 tg, 22.1GB) vs APEX-I Balanced (60.4 tg, 24.4GB):
- Quality가 TG 더 빠르고 VRAM도 적게 쓴다. 이름은 Quality인데 Balanced보다 더 효율적이다.
- 근데 quant detection이 안 되어서 DB에 unknown 태그로 들어갔다. model_scanner.py 정규식에 APEX-I가 없어서 그런 듯.
결론 및 추천
최고의 TG 속도 🔥
SC117 Ornith-1.0-35B-MTP-APEX-I-Quality — 61.8 tok/s
최고의 VRAM 효율 💰
noctrex Ornith-1.0-35B-MXFP4_MOE — 57.2 tg @ 18.71GB
VRAM 1GB당 3.06 tok/s. 효율성 1등.
PP 처리 속도 1위 ⚡
s-batman ornith-1.0-35b-MXFP4_MOE-MTP — 2200 tg @ 20.5GB
최악의 선택 💀
bartowski Q6_K — 47.2 tg @ 28.1GB. 느리고 무겁다.
필자의 생각 (삽질 요약)
Ornith-1.0은 아이디어는 좋은데 DGX Spark에서 쓰기엔 아직 물이 덜 오른 모델이다.
Qwen3.5-35B-A3B 기반에 RL post-training으로 agentic coding을 강화했다는 컨셉은 매력적이지만, llama.cpp에서의 추론 최적화는 아직 개선의 여지가 많다. 특히 이번 벤치마크는 일반 텍스트(hellaswag) 기준이라, Ornith의 진짜 강점인 코딩 태스크에서의 MTP 효과를 제대로 측정하지 못했을 가능성이 크다.
아마도 문제는: 1. Ornith이 아직 llama.cpp 생태계에 완전히 최적화되지 않음 — NVFP4/MXFP4 quantizer 실험은 좋았지만 MTP 플래그가 일반 텍스트 벤치마크에선 역효과 2. MTP 헤드가 post-training 중에 손상되었거나 비활성화됨 — RL fine-tuning이 MTP 헤드 가중치에 영향을 줬을 가능성 3. 벤치마크 도메인 미스매치 — 코딩 특화 모델에 일반 상식 추론 테스트를 적용한 한계
그래도 DeepReinforce AI의 5인 팀이 MIT 라이선스로 이 규모의 모델을 공개한 것은 대단한 일이다. 앞으로 업데이트가 더 되면 DGX Spark에서도 제 성능을 낼 수 있을 거라고 본다. 그리고 9B 버전도 있으니 그건 또 다른 이야기 — 다음에 한번 돌려보자.
추신: 벤치마크 돌리는 중간에 dropcache cron이 돌아서 캐시가 날아가서 첫 번째 hellaswag perplexity 측정이 fail났다. 그 부분은 NVFP4 모델 데이터가 하나 비었으니 나중에 재측정해야겠다. 🫠
📖 관련 글 - DGX Spark GB10 최적화 모델 총정리 - North Mini Code 1.0 GGUF 벤치마크: 9개 양자화 완전 비교 - Nex-N2-mini UD 버전 벤치마크: bartowski와 비교 - Qwen3.6 llama.cpp → vLLM + DFlash
벤치마크 데이터: DGX Spark GB10, Hermes Agent + bench_runner.py run #019, 2026-06-30