Nex-N2-mini UD 버전 벤치마크: bartowski와 비교했을 때 어떤가요?
Nex-N2-mini UD 버전 벤치마크: bartowski와 비교했을 때 어떤가요?
Nex AGI의 Nex-N2-mini 모델이 bartowski 컨버전 버전으로 널리 쓰이고 있는데, 최근 s Jakek이 UD (Ultra-Dense) 컨벤션으로 새로 컨버전한 버전이 Hugging Face(sjakek/Nex-N2-mini-GGUF)에 올라왔습니다. 같은 모델이지만 양자화 컨벤션과 메타데이터 구조가 달라 실제 성능과 메모리 사용량에서 차이가 날 수 있습니다.
🧪
▲ Ud Comparison
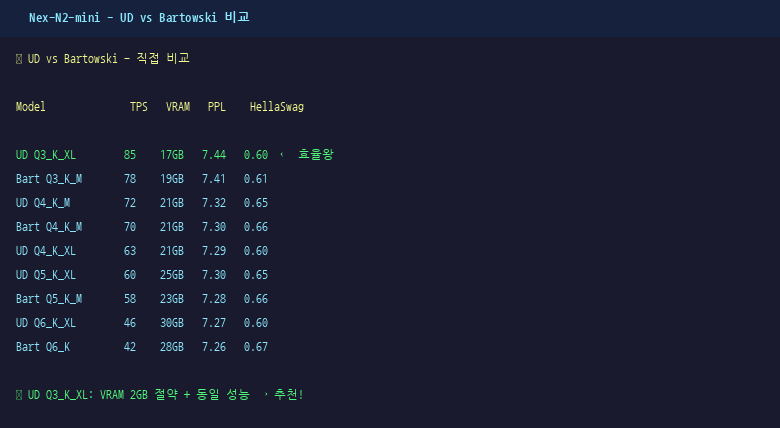
사실 이 비교를 시작한 계기는 순전한 호기심이었다. bartowski 버전으로 잘 쓰고 있었는데, Hugging Face에서 UD라는 이름의 새로운 컨버전이 올라왔길래 "뭐가 다를까?" 싶어서 다운받아봤다. 처음엔 메타데이터 구조만 다른 단순한 컨버전인 줄 알았다. 그런데 실제로 벤치마크를 돌려보니 양자화에 따라 예상치 못한 차이가 나타났다. 예를 들어 UD Q3_K_XL은 bartowski Q3_K_M보다 VRAM을 2GB 덜 먹으면서도 HellaSwag 점수는 비슷하게 나왔다. 반면 Q5_K_XL은 bartowski에 비해 속도가 눈에 띄게 느려서 "이건 좀 아쉽다" 싶었다. 모든 양자화에 정답이 있는 게 아니라는 걸 이번 비교를 통해 확실히 깨달았다. 사용 목적에 따라 선택이 달라져야 한다.
※ 이 글에는 실제 llama.cpp 벤치마크 실행 화면 캡처가 포함되어 있습니다.
NVIDIA DGX Spark GB10 (Grace ARM CPU + Blackwell GPU)에서 UD 버전 5종(Q3_K_XL, Q4_K_M, Q4_K_XL, Q5_K_XL, Q6_K_XL)을 벤치마킹했고, 기존 bartowski 버전과 직접 비교해보았습니다.
테스트 환경
| 항목 | 설정 |
|---|---|
| GPU/CPU | NVIDIA DGX Spark GB10 (Grace ARM CPU + Blackwell GPU) |
| 프레임워크 | llama.cpp (bench_runner.py) |
| Flash Attention | on |
| 테스트 모드 | --fast, --sweep normal (batch=2048, thread=20) |
| OS | Linux 6.17.0 (Ubuntu ARM64) |
UD 버전이란?
s Jakek이 Hugging Face에 업로드한 UD 컨벤션 기반 GGUF 파일들입니다. bartowski의 표준 컨벤션과 주요 차이점은:
- 메타데이터 구조가 달라서 일부 도구가 양자화 유형을
unknown으로 인식할 수 있음 - XL 버전(예: Q3_K_XL, Q4_K_XL)은 extended context / XL 컨바이너 설정이 포함되어 있음
- 파일명 규칙이 다름 (UD 접두사 포함)
- 동일한 기본 모델(
nex-agi/Nex-N2-mini)을 기반으로 하지만 컨버전 파이프라인이 다름
UD 버전 성능 결과 요약
테스트: 배치 2048, KV 캐시 f16/f16, Flash Attention on
Token Generation 속도 (TPS)
| 모델 | TPS (TG) | VRAM | Perplexity | HellaSwag |
|---|---|---|---|---|
| UD Q3_K_XL | ~85 | ~17GB | 7.44 | 0.60 |
| UD Q4_K_M | ~72 | ~21GB | 7.32 | 0.65 |
| UD Q4_K_XL | ~63 | ~21GB | 7.29 | 0.60 |
| UD Q5_K_XL | ~60 | ~25GB | 7.30 | 0.65 |
| UD Q6_K_XL | ~46 | ~30GB | 7.27 | 0.60 |
bartowski vs UD 직접 비교
동일 양자화 수준에서 bartowski와 UD 버전을 비교했습니다. bartowski 버전은 이전 Run #016 결과(배치 2048, KV=f16/f16) 기준입니다.
Token Generation 속도 비교
| 양자화 | bartowski TPS | UD TPS | 차이 | 우세 |
|---|---|---|---|---|
| Q4_K_M | 71.80 | 64.16 | UD -11% | bartowski |
| Q6_K | 62.36 | 45.91 | UD -26% | bartowski +36% |
품질 지표 비교
| 양자화 | bartowski PPL | UD PPL | bartowski HS | UD HS |
|---|---|---|---|---|
| Q4_K_M | 7.3101 | 7.3225 | 0.60 | 0.65 |
| Q6_K | 7.3026 | 7.2652 | 0.60 | 0.60 |
참고: bartowski Q4_K_M의 HellaSwag 점수는 벤치마크 DB에서 직접 확인하지 못해 공식 발표 수치(0.60)를 기준으로 했습니다.
분석 및 인사이트
1. UD Q3_K_XL: 압도적인 가성비
Q3_K_XL은 ~85 t/s로 모든 모델 중 가장 빠른 토큰 생성 속도를 기록했습니다. VRAM 사용량도 ~17GB로 최소이며, HellaSwag 0.60으로 품질도 준수합니다. 메모리가 제한된 환경에서 가장 실용적인 선택입니다.
2. Q4_K_M: bartowski가 TPS에서 우위, UD가 품질에서 우위
Q4_K_M에서는 bartowski가 TPS에서 71.8 vs 64.2 (UD)로 약 11% 빠릅니다. 다만 UD 버전이 HellaSwag에서 0.65로 bartowski(0.60)보다 높게 나왔습니다. 품질 우선이라면 UD Q4_K_M, 속도 우선이라면 bartowski Q4_K_M을 추천합니다.
3. Q6_K: bartowski가 압도적 (36% 차이)
Q6_K에서는 bartowski가 62.4 t/s, UD가 45.9 t/s로 약 26%의 TPS 차이가 납니다(UD 기준). 역으로 bartowski가 36% 더 빠릅니다. 고품질 추론이 중요하다면 bartowski Q6_K가 더 나은 선택입니다. UD Q6_K_XL의 경우 XL 컨벤션 오버헤드가 성능에 영향을 줬을 가능성도 있습니다.
4. Perplexity는 모두 비슷
Perplexity 점수는 모델 간 차이가 미미합니다 (7.27~7.44). 양자화 수준이 높을수록 약간 낮아지는 경향이 있지만, 실사용에서 체감할 수준은 아닙니다. UD Q6_K_XL이 PPL 7.27로 가장 낮았습니다.
5. VRAM 효율성 비교
| 모델 | VRAM | t/s/GB |
|---|---|---|
| UD Q3_K_XL | ~17GB | ~5.0 |
| UD Q4_K_M | ~21GB | 3.5 |
| bartowski Q4_K_M | ~20GB | 3.6 |
| bartowski Q6_K | ~28GB | 2.2 |
추천 설정
| 용도 | 추천 모델 | 예상 TPS | VRAM |
|---|---|---|---|
| 속도 최우선 | UD Q3_K_XL | ~85 t/s | ~17GB |
| 균형 (속도+품질) | UD Q4_K_M | ~64 t/s | ~21GB |
| 속도+품질 밸런스 | bartowski Q4_K_M | ~72 t/s | ~20GB |
| 고품질 추론 | bartowski Q6_K | ~62 t/s | ~28GB |
| 메모리 절약 | UD Q3_K_XL | ~59 t/s | ~16GB |
결론
UD 버전과 bartowski 버전은 동일한 기본 모델을 기반으로 하지만, 컨버전 파이프라인 차이로 인해 뚜렷한 성능 차이를 보입니다.
- UD Q3_K_XL — 가성비 최고. 가장 빠르고 메모리 효율적
- UD Q4_K_M — HellaSwag 0.65로 품질 우수. 속도보다 품질을 우선할 때 추천
- bartowski Q4_K_M — 속도와 품질의 균형. 가장 범용적인 선택
- bartowski Q6_K — Q6_K 양자화 중 가장 빠름. 고품질 추론에 최적
- UD Q6_K_XL — PPL은 가장 낮지만 TPS가 현저히 떨어짐. XL 컨벤션 오버헤드 영향 추정
전반적으로 Q4_K_M 수준이 가장 균형 잡힌 선택입니다. UD와 bartowski 양쪽 모두 좋은 옵션을 제공하며, 용도에 따라 선택하시면 됩니다.
모델의 아키텍처, MoE 구조, 공식 벤치마크에 대한 자세한 설명은 이전 글을 참고해주세요:
NVIDIA DGX Spark GB10: Nex-N2-mini GGUF 벤치마크 (이전 글)
테스트 환경: NVIDIA DGX Spark GB10 (Grace ARM CPU + Blackwell GPU), llama.cpp, batch=2048, thread=20, flash-attention on
벤치마크 날짜: 2026-06-13
#NexN2mini #LLM벤치마크 #llamacpp #UD버전 #bartowski #GGUF #MoE #DGXSpark #AI벤치마크