ChatGPT와 Gemini는 왜 서로 다른 답을 했을까? - MeshLLM 심화편
ChatGPT와 Gemini는
왜 서로 다른 답을 했을까?
몇 주 전, 허깅페이스에서 이상한 GGUF 파일 구조를 발견했다. 레이어 단위로 쪼개진 수백 GB의 모델 파일들. 처음엔 "아, 분할 다운로드용이겠지"라고 생각했다.
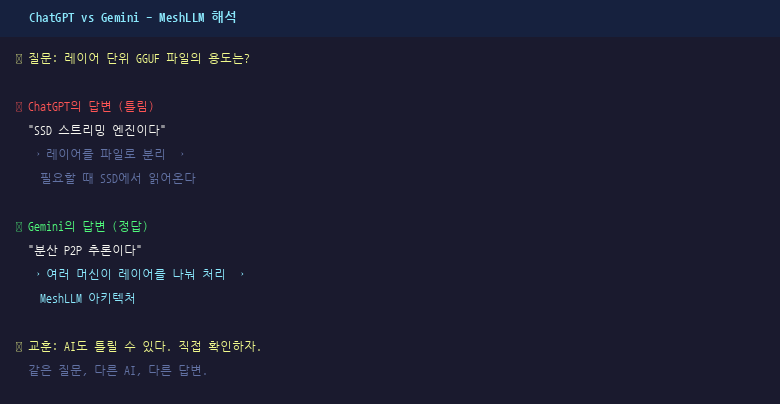
그런데 궁금해서 ChatGPT와 Gemini에게 각각 물어봤다. 두 AI가 내놓은 해석이 비슷하면서도 달랐다. 그리고 그 차이가 바로 MeshLLM의 본질을 파헤치는 열쇠가 되었다.
▲ Chatgpt Vs Gemini
🔮 첫 번째 가설: "SSD 스트리밍 엔진?"
ChatGPT의 초기 설명을 들었을 때, 꽤 그럴듯했다.
- 레이어가 파일로 분리되어 있다 → 필요한 순간에 읽어올 수 있다
- 수백 GB를 한 번에 올릴 필요 없다 → SSD를 거대한 메모리처럼 활용할 수 있다
- 미래에는 초거대 모델도 돌릴 수 있을지도 → 개인용 머신으로 1T 모델?
특히 DGX Spark 같은 장비를 가지고 노는 입장에서는 상당히 매력적인 이야기다. "혹시 이것이 거대 모델을 SSD에서 스트리밍하는 미래 기술의 시작인가?" 솔직히 말해 순간 혹했다.
💡 왜 혹했나? — 레이어가 파일로 나뉘었다 = "필요할 때만 읽는다" = "SSD 캐싱". 이 논리는 처음엔 합리적으로 보였다. 실제로 GGUF 자체가 mmap 기반 스트리밍을 지원하니까.
🤔 그런데 뭔가 이상했다
자료를 계속 뒤져보는데, 이상한 점이 보였다. ChatGPT가 반복적으로 언급하던 "SSD 스트리밍"이라는 단어는 공식 문서에서 그렇게 자주 등장하지 않았다.
오히려 다음 단어들이 계속 등장했다.
설명을 읽을수록 초점은 SSD가 아니었다. "분산 추론"에 있었다.
레이어를 쪼갠 이유도 SSD 캐싱보다는 여러 컴퓨터에 나눠 배치하기 위한 목적처럼 보였다.
MeshLLM은 SSD 스트리밍 프로젝트가 아니라
분산 GGUF 추론 프로젝트다.
🗣️ Gemini의 반박(?)
흥미로운 점은 이후 Gemini에게 다시 자료를 보여주자, 스스로 설명을 수정했다는 것이다.
Gemini의 수정된 해석:
"MeshLLM의 본질은 분산 추론이 맞습니다. SSD 스트리밍은 핵심 기능이 아닙니다. 다만 레이어를 분리한 구조가 미래의 스트리밍 엔진으로 발전하기 좋은 토대는 될 수 있습니다."
이 답변은 꽤 설득력이 있었다. 왜냐하면 현재 구현과 미래 가능성을 분리해서 설명하기 시작했기 때문이다.
🔍 두 AI의 해석 차이:
- ChatGPT: 미래 가능성을 현재 구현처럼 설명하는 경향
- Gemini: mmap과 OS 캐시 동작을 MeshLLM의 핵심 기능으로 과장하는 경향
둘 다 완전히 틀린 것은 아니다. 다만 현재 구현과 미래 가능성을 섞어버린 순간 이야기가 이상해진다.
📊 현재 구현 vs 미래 가능성
자료를 교차 검증하면서 정리해본 테이블이다.
| 기능 | 현재 확인 가능 | 추정 / 미래 가능성 |
|---|---|---|
| 레이어 분리 | ✓ | — |
| 분산 추론 | ✓ | — |
| 노드 간 레이어 배치 | ✓ | — |
| SSD 기반 스트리밍 | ? | 가능성 있음 |
| MoE Expert 동적 로딩 | ? | 상당히 흥미로움 |
🧠 오히려 진짜 흥미로운 부분은 MoE다
자료를 조사하면서 개인적으로 더 흥미로웠던 것은 SSD가 아니라 MoE(Mixture of Experts)였다.
Dense 모델은 모든 레이어를 모든 토큰이 통과한다. 하지만 MoE 모델은 다르다. 토큰마다 일부 Expert만 활성화된다.
만약 미래에 이런 구조가 가능해진다면?
자주 사용하는 Expert → RAM에 유지 (일반 대화, 코딩, 한국어)
거의 사용하지 않는 Expert → SSD에 보관 (번역, 특수 분야)
필요할 때만 불러오기 → VRAM은 현재 활성화된 Expert만
예를 들어 코딩 작업을 주로 한다면:
이런 식으로 메모리 상에 필요한 Expert만 올리는 방식도 상상할 수 있다.
물론 현재 공개된 MeshLLM이 이렇게 동작한다는 의미는 아니다. 하지만 레이어가 이미 분리되어 있다는 사실은 이런 방향으로 발전하기 좋은 기반이 될 수 있다.
💡 개인적 생각: MoE 모델에서 "어떤 Expert가 활성화될지"를 예측할 수 있다면, 사전 로딩이 가능하다. 사용자 패턴을 학습한 추론 엔진이 등장한다면, 이 이론은 현실이 될 수 있다.
🎓 결국 AI도 자료 해석의 차이가 있다
이번 경험에서 가장 재미있었던 점은 기술 자체보다 AI들의 반응이었다.
미래 가능성을 현재 구현처럼 설명하는 경향. "SSD 스트리밍"을 강조했지만, 이는 추론이지 현재 기능은 아님.
mmap과 OS 캐시 동작을 MeshLLM의 핵심 기능으로 과장하는 경향. 기술적 이해는 깊지만 구현과의 구분이 모호함.
둘 다 완전히 틀린 것은 아니었다. 다만 현재 구현과 미래 가능성을 섞어버린 순간 이야기가 이상해졌다.
결국 답은 직접 자료를 읽고 교차 검증하는 과정에서 나왔다.
✍️ 마무리
현재 시점에서 내가 내린 결론은 단순하다.
MeshLLM은 SSD 스트리밍 프로젝트가 아니다.
분산 추론 프로젝트다.
하지만 동시에,
레이어를 잘게 분리한 현재 구조는 미래의 SSD 스트리밍,
Expert 캐싱, 고급 메모리 관리 기술로 발전할 수 있는
상당히 흥미로운 설계이기도 하다.
그래서 조사 전보다 오히려 더 기대하게 됐다.
MeshLLM 자체보다도, 그 구조가 앞으로 어디까지 발전할 수 있을지 말이다.