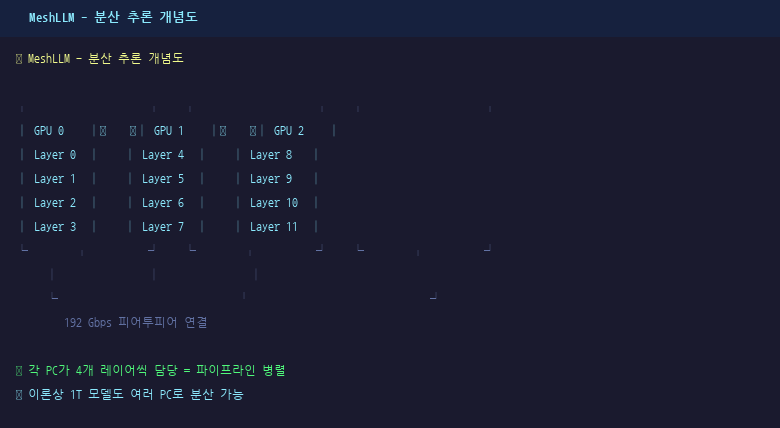
초거대 AI 모델의 미래? 레이어를 쪼개서 여러 PC에 나눠 돌리는 기술
초거대 AI 모델의 미래?
레이어를 쪼개서 여러 PC에 나눠 돌리는 기술
허깅페이스를 탐사하다 우연히 발견한 이상한 파일 구조 하나가, 생각보다 깊은 기술 세계로 나를 이끌었다.
MiniMax M3 모델을 살펴보던 중, 평소 보던 GGUF 파일과 완전히 다른 형태를 목격했다.
model.gguf          (전체 1개 파일)
model-q4.gguf
model-q8.gguf
shared/embeddings.gguf    (1.2 GB)
shared/output.gguf        (1.2 GB)
layers/layer-000.gguf     (수 GB)
layers/layer-001.gguf     (수 GB)
...
layers/layer-059.gguf     (수 GB)
파일이 수십 개로 나뉘어 있었고, 총 크기는 무려 247.2 GB. 처음에는 단순한 다운로드 편의를 위한 분할 파일인 줄 알았지만, 실제로는 완전히 다른 목적을 가진 프로젝트였다.
▲ Meshllm
Mesh LLM이란?
GitHub 스타 859개, 1,400회 이상 커밋이 쌓인 활발한 오픈소스 프로젝트다. 핵심 아이디어는 간단하다.
여러 대의 컴퓨터를 하나의 거대한 AI 추론 시스템으로 묶는다
기존 로컬 LLM 환경에서는 모델 전체를 하나의 GPU나 시스템 메모리에 올려야 했다. 하지만 200B급 모델이나 초대형 MoE 모델이 등장하면서 이 방식은 한계에 부딪혔다.
┌──────────────┐     ┌──────────────┐     ┌──────────────┐
│   PC A       │     │   PC B       │     │   PC C       │
│ (GB10, 128GB)│     │(RTX 5070 Ti) │     │(Mac Studio)  │
│              │     │              │     │  (128GB)     │
│ Layer  0~20  │     │ Layer 21~40  │     │ Layer 41~60  │
└──────────────┘     └──────────────┘     └──────────────┘
       │                    │                    │
       └────────────────────┴────────────────────┘
                        │
              localhost:9337/v1/chat/completions
              (OpenAI 호환 단일 API 엔드포인트)
각 노드가 모델의 일부를 맡아 계산하고, 결과를 OpenAI 호환 API(localhost:9337/v1)로 하나로 묶어낸다. 사용자는 단순히 curl localhost:9337/v1/chat/completions만 호출하면 된다.
📦 레이어 패키지 구조
허깅페이스의 meshllm/MiniMax-M3-UD-Q4_K_XL-layers 리포지토리를 보면 구조가 명확하다.
| 구성 요소 | 경로 | 크기 |
|---|---|---|
| 임베딩 | shared/embeddings.gguf | 1.2 GB |
| 출력 헤드 | shared/output.gguf | 1.2 GB |
| 메타데이터 | shared/metadata.gguf | 7.9 MB |
| 변환기 레이어 (60개) | layers/layer-000~059.gguf | 244.8 GB |
| 총합 | 247.2 GB | |
단일 GGUF 파일이 60개의 레이어 파일로 분리된 것이다. 각 레이어 파일은 Mesh LLM 클러스터의 각 노드가 독립적으로 다운로드한다.
예를 들어 235B 모델의 경우, 한 노드는 layer 70~94만 다운로드하면 된다. 전체 134 GB 중 약 35 GB만 내려받으면 되는 것.
🧠 Dense vs MoE: 다른 분할 전략
Mesh LLM은 모델 아키텍처에 따라 다른 분할 방식을 사용한다.
파이프라인 병렬화 — 레이어를 순차적으로 분할. 각 노드가 연속된 레이어 범위를 담당한다.
Expert 샤딩 — 각 노드에 Expert를 분산 배치. 추론 시 활성화되는 Expert만 실행하므로 노드 간 통신을 최소화한다.
MoE 모델의 경우 실제로 활성화되는 Expert는 전체의 일부에 불과하므로, 네트워크 오버헤드를 크게 줄일 수 있다.
⚡ GB10 환경에서의 가능성
나는 현재 NVIDIA DGX Spark (GB10, 128GB 유니파이드 메모리)와 RTX 5070 Ti 환경을 사용하고 있다.
이 환경에서 항상 마주하는 질문이 하나 있다.
"더 큰 모델을 돌릴 수는 없을까?"
GB10의 128GB 메모리는 훌륭하지만, MiniMax M3 (247 GB)나 Qwen3-235B급 모델을 돌리기엔 부족하다.
💡 가능성 있는 시나리오
GB10에 다른 머신 (예: Mac Studio M2 Ultra의 128GB 등)을 10GbE로 연결하면, 이론적으로 총 256 GB 이상의 GPU 접근 가능 메모리가 확보된다. 실제 테스트 사례에서는 10GbE 직접 연결이 9.41 Gbps의 스루풋을 기록했으며, 두 머신을 조합하면 200B 파라미터를 넘는 모델도 로컬에서 돌릴 수 있는 가능성이 열린다.
🚀 설치와 사용
Mesh LLM 설치부터 실제 호출까지의 흐름은 이렇다.
# 1. 각 노드에 설치
curl -fsSL https://raw.githubusercontent.com/Mesh-LLM/mesh-llm/main/install.sh | bash

# 2. 공개 메시에 참여
mesh-llm serve --auto

# 3. 상태 확인 (웹 콘솔: localhost:3131)
curl -s http://localhost:9337/v1/models

# 4. API 호출 (OpenAI 호환)
curl http://localhost:9337/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"GLM-4.7-Flash-Q4_K_M","messages":[{"role":"user","content":"hello"}]}'
특히 웹 콘솔(localhost:3131)에서 각 노드의 VRAM 사용량, 로딩된 모델, 메시 토폴로지를 실시간으로 확인할 수 있다.
💭 생각: Expert 캐싱의 가능성
Mesh LLM을 조사하다 한 가지 의문이 들었다. 모델 전체를 항상 메모리에 올려둘 필요가 있을까?
특히 최신 MoE 모델들은 전체 파라미터가 수백 B 규모지만, 실제로 추론 시 활성화되는 Expert는 일부에 불과하다.
그렇다면 이런 계층적 구조도 가능하지 않을까?
SSD (저속, 대용량)
 ├ 드문 Expert (번역, 특수 분야)

RAM (고속)
 ├ 자주 사용하는 Expert (일반 대화, 코딩)

VRAM (최고속)
 ├ 현재 활성화된 Expert
코딩 작업을 하면 코딩 관련 Expert가, 번역을 하면 번역 Expert가 자동으로 VRAM으로 올라오는 구조다.
물론 실제 구현은 쉽지 않다. Expert 역할이 명확히 분리되지 않았고, SSD와 메모리 간 대역폭 차이도 상당하다. 하지만 초거대 모델 시대가 계속된다면, 언젠가는 이런 추론 엔진이 등장할 가능성이 충분히 있다.
🔍 현재 한계
- 네트워크 대역폭이 병목이 될 수 있음 (로컬 이더넷 기준)
- 여러 대의 물리 머신이 필요함
- 아직 초기 단계 — 안정성보다 기능 개발에 집중 중
하지만 한 가지는 분명하다.
앞으로의 경쟁은 단순히 더 큰 모델을 만드는 것이 아니라,
그 거대한 모델을 어떻게 효율적으로 실행할 것인가에 가까워질 것이다.
참고 자료
- Mesh LLM GitHub — 공식 저장소 (Apache 2.0)
- MiniMax-M3 레이어 패키지 — 허깅페이스
- Mesh LLM 공식 문서