Qwen-Image 2.1 — 새로 나온 오픈웨이트 이미지 모델 로컬 구동기
새로운 이미지 모델의 등장
유튜브를 둘러보다 Qwen-Image 2.1 Low VRAM이라는 제목이 눈에 들어왔다.
처음에는 기존 Qwen Image Edit 계열의 파생형인가 싶었다. 그런데 확인해보니 2026년 9월 20일에 공개된 아예 새로운 모델이었다.
모델 카드도 바로 열어봤다. 오픈웨이트 모델인데 공개 비교표에서 점수가 꽤 높았고, 무엇보다 최대 10장의 레퍼런스 이미지를 직접 넣어 편집할 수 있다는 점이 눈에 띄었다. 여러 이미지를 참고하면서 인물이나 제품의 정체성을 유지하는 작업까지 한 모델 안에서 처리할 수 있다.
이 정도면 직접 돌려보는 게 빠르다.
고민할 것 없이 로컬 ComfyUI 환경에 바로 얹어 테스트했다.
결론부터 말하면 기대 이상이었다.
로컬에서 꽤 간편하게 GPT Image에서 하던 레퍼런스 편집 흐름을 흉내낼 수 있는 모델이 나온 것 같다.
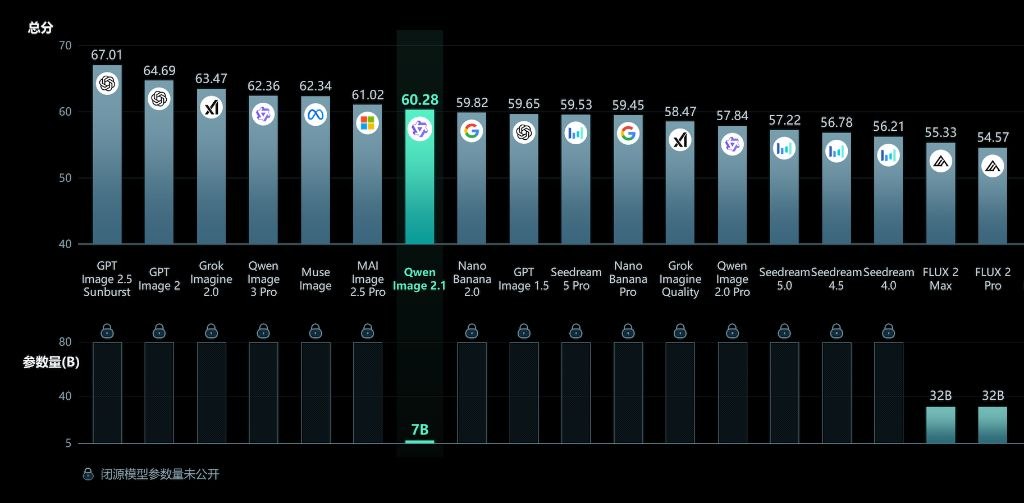
공개 비교표에서 Qwen-Image 2.1은 7B급 모델임에도 상위권에 위치했다.
Qwen-Image 2.1은 어떤 모델인가
Qwen-Image 2.1은 텍스트 기반 이미지 생성과 레퍼런스 기반 이미지 편집을 함께 지원하는 7B급 이미지 모델이다.
텍스트 프롬프트만으로 이미지를 새로 만들 수 있고, 레퍼런스 이미지를 넣어 인물이나 제품의 정체성을 유지한 채 의상·배경·포즈를 바꾸는 작업도 가능하다.
이번에 눈에 들어온 기능은 다음과 같다.
- 텍스트 기반 이미지 생성
- 레퍼런스 기반 이미지 편집
- 최대 10장 레퍼런스 이미지 입력
- 인물·제품 정체성 보존
- RGBA 투명 배경 출력
- 다양한 종횡비 지원
- ComfyUI용 공식 리패키지와 워크플로 제공
생성과 편집이 한 모델에 묶여 있어서 별도 파이프라인을 복잡하게 조합할 필요가 없다는 점도 편했다.
Qwen 계열 이미지 모델은 이전에도 써볼 만했지만, 이번 2.1은 여러 레퍼런스를 직접 넣고 편집하는 흐름까지 한 번에 가져갈 수 있어서 새 모델 테스트용으로는 꽤 매력적이었다.
로컬 테스트 구성
이번에는 원본 Diffusers 저장소 대신 ComfyUI에서 바로 쓰기 쉬운 Comfy-Org/Qwen-Image-2.1 리패키지판을 사용했다.
실제로 받은 파일은 세 개다.
| 역할 | 파일 | 크기 |
|---|---|---|
| Diffusion model | qwen_image_2.1_int8_convrot.safetensors | 약 7.26GB |
| Text encoder | qwen3vl_8b_int8_convrot.safetensors | 약 9.35GB |
| VAE | qwen_image_2.1_vae_bf16.safetensors | 약 0.68GB |
| 합계 | INT8 diffusion + INT8 text encoder + BF16 VAE | 약 17.3GB |
이번 테스트 구성은 정리하면 다음과 같다.
Diffusion INT8 + Qwen3VL 8B INT8 + VAE BF16
모델 파일 전체가 약 17.3GB라 GB10에서는 부담 없이 테스트할 수 있었다.
ComfyUI 배치 경로는 다음과 같다.
ComfyUI/models/
├── diffusion_models/qwen_image_2.1_int8_convrot.safetensors
├── text_encoders/qwen3vl_8b_int8_convrot.safetensors
└── vae/qwen_image_2.1_vae_bf16.safetensors
DGX Spark GB10에서 실행
테스트 환경은 다음과 같다.
- 하드웨어: NVIDIA DGX Spark GB10
- ComfyUI: 0.37.0
- PyTorch: 2.12.1+cu130
- Python: 3.12.3
- Comfy Kitchen: 0.2.35
- Workflow templates: 0.11.66
- 실행 방식: systemd 서비스
- 주요 플래그:
--reserve-vram 8 --disable-pinned-memory
처음에는 기존 ComfyUI 0.36.0에서 모델 파일 자체는 보였지만 Qwen-Image 2.1 전용 노드가 없었다.
확인해보니 upstream에 2.1 지원이 추가된 상태였고, ComfyUI를 0.37.0으로 업데이트한 뒤 관련 노드가 정상적으로 잡혔다.
처음 임시 백그라운드 프로세스로 실행했을 때는 4GB cgroup 메모리 제한을 물려받는 문제가 있었다. 이건 모델 문제가 아니라 실행 환경 문제였고, systemd 서비스로 전환한 뒤에는 정상적으로 GB10의 메모리를 사용할 수 있었다.
이후부터는 ComfyUI API를 통해 반복 생성하고 결과 파일까지 자동으로 저장하는 방식으로 테스트했다.
실제로 해본 것
가장 먼저 궁금했던 건 레퍼런스 한 장으로 인물의 느낌을 얼마나 유지하면서 장면을 바꿀 수 있느냐였다.
기본 레퍼런스 이미지를 하나 넣고, 얼굴과 전체적인 인상은 유지하면서 의상·포즈·배경을 바꾸는 편집부터 시작했다.
공통 설정은 다음과 같다.
- 레퍼런스 이미지: 1장
- 워크플로: ComfyUI Image Edit
- Steps: 25
- Sampler: Euler
- Scheduler: Simple
- CFG: 1.0
- 고정 seed 사용
- API 제출부터 결과 파일 저장까지 시간 측정
먼저 기본 편집, 포즈·의상 변경, 세로 전신 이미지까지 세 가지를 확인했다.
| 테스트 | 해상도 | 소요 시간 | 확인한 내용 |
|---|---|---|---|
| 기본 편집 | 1024×1024 | 28.22초 | 얼굴·헤어 유지 + 의상·배경 변경 |
| 포즈·의상 변경 | 1024×1024 | 28.05초 | 3/4 포즈, 손동작, 착장 변경 |
| 세로 전신 | 720×1280 | 30.05초 | 전신·신발 포함 9:16 이미지 |
1024 정사각형 편집은 약 28초, 720×1280 세로 전신 이미지는 약 30초 정도였다.
속도도 괜찮았지만, 더 마음에 들었던 건 편집 과정이 간단했다는 점이다. 기본 레퍼런스를 넣고 원하는 장면을 설명하는 것만으로 캐릭터 바리에이션을 빠르게 만들 수 있었다.
첫인상은 꽤 좋았다
기본 편집에서는 얼굴과 헤어, 전체적인 인상이 꽤 잘 유지됐다.
포즈를 3/4 방향으로 돌리고 손동작을 추가하거나 드레스와 재킷을 바꿔도 인물의 느낌이 크게 흔들리지 않았다. 9:16 전신 이미지에서도 머리부터 신발까지 자연스럽게 들어왔고 얼굴 인상도 유지됐다.
여기까지 확인하고 나니 단순한 기능 테스트로 끝내기보다, 같은 캐릭터를 여러 장르와 상황으로 바꿔보면 더 재미있겠다는 생각이 들었다.
그래서 GPT Image로 만들어둔 유라 에이전트 기본 프로필 이미지 한 장을 기준 레퍼런스로 두고, Qwen-Image 2.1에서 스타일을 크게 바꿔봤다.
한 장의 레퍼런스로 어디까지 바뀌나
기준 레퍼런스
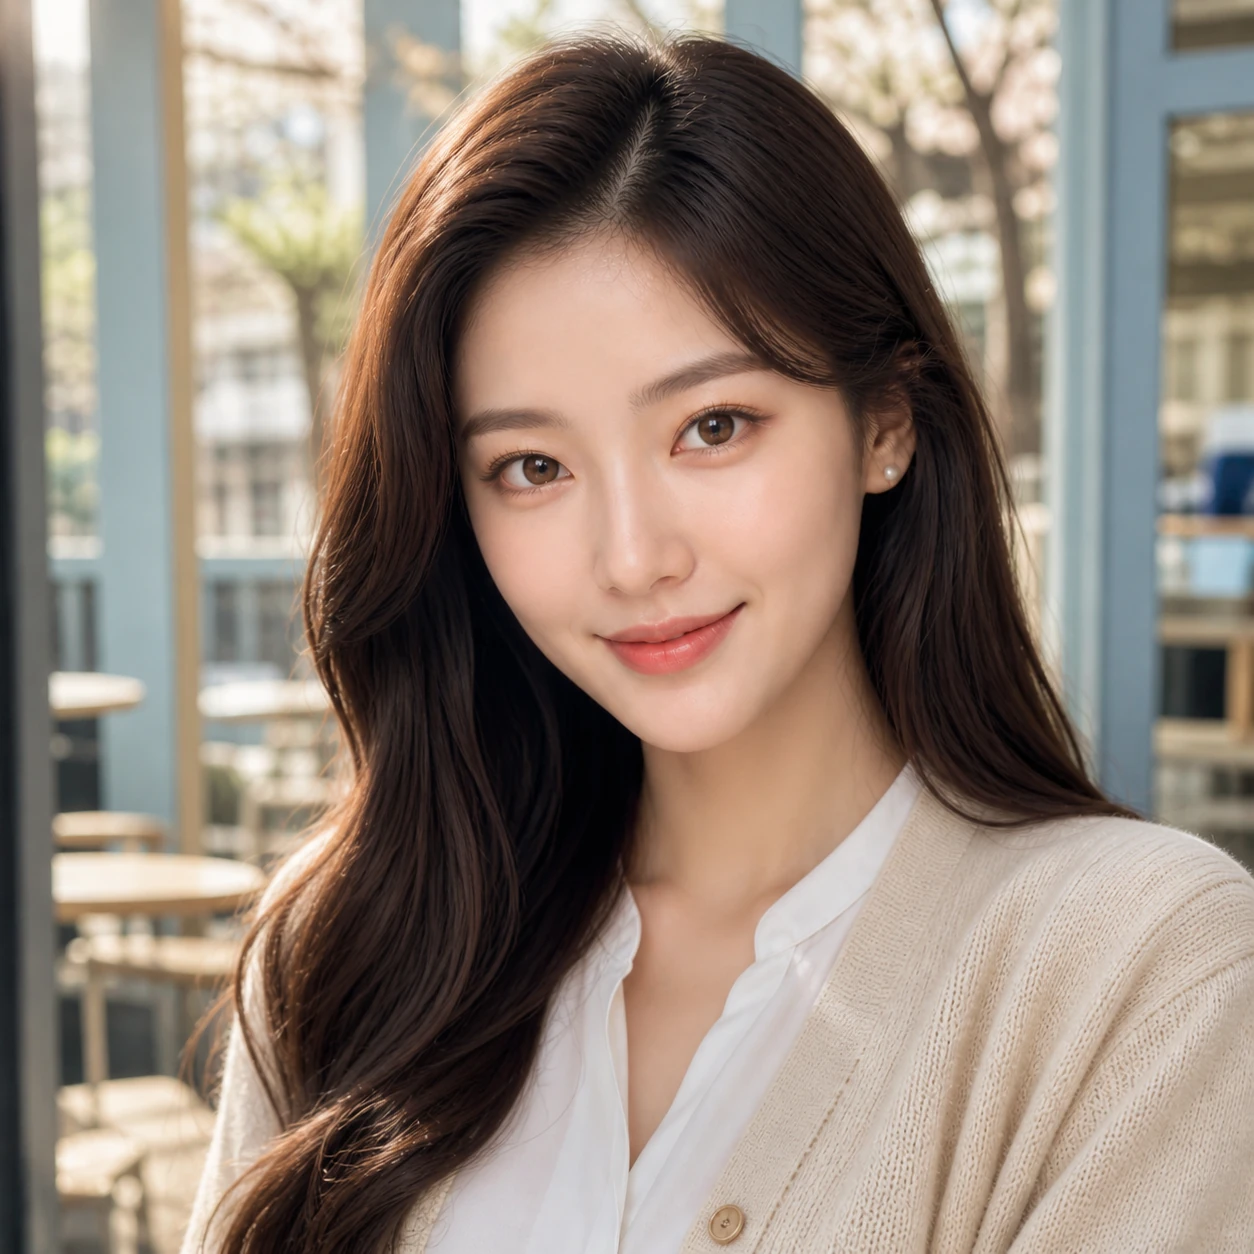
GPT Image로 만든 유라 에이전트 기본 프로필. 아래 모든 이미지는 이 한 장을 기준으로 Qwen-Image 2.1에서 편집했다.
기준 이미지는 정면에 가까운 프로필 컷이다.
얼굴형, 눈매, 헤어스타일과 전체적인 인상을 이 이미지에서 가져간다.
여기서 배경과 의상, 장르를 크게 바꿔봤다.
사이버틱 에이전트
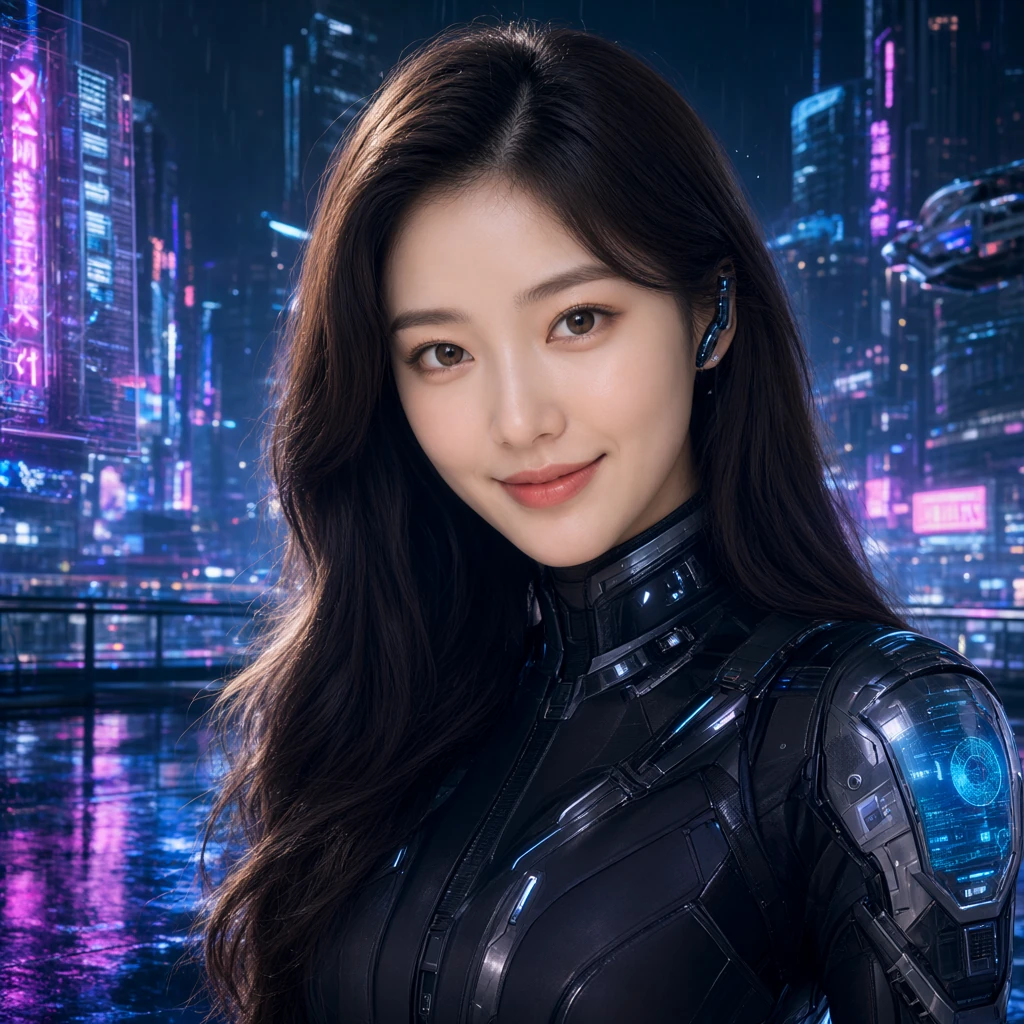
네온 도시와 전술 장비를 더한 미래형 에이전트 버전.
배경을 미래 도시로 바꾸고 의상도 완전히 다른 사이버틱 슈트로 교체했다.
스타일 변화가 큰 편인데도 기준 이미지의 얼굴과 헤어, 전체적인 인상이 꽤 자연스럽게 이어졌다. 이번 샘플 가운데 장르 변화가 가장 큰 쪽에 속하지만 같은 캐릭터라는 느낌은 분명하게 남았다.
카페의 일상 장면
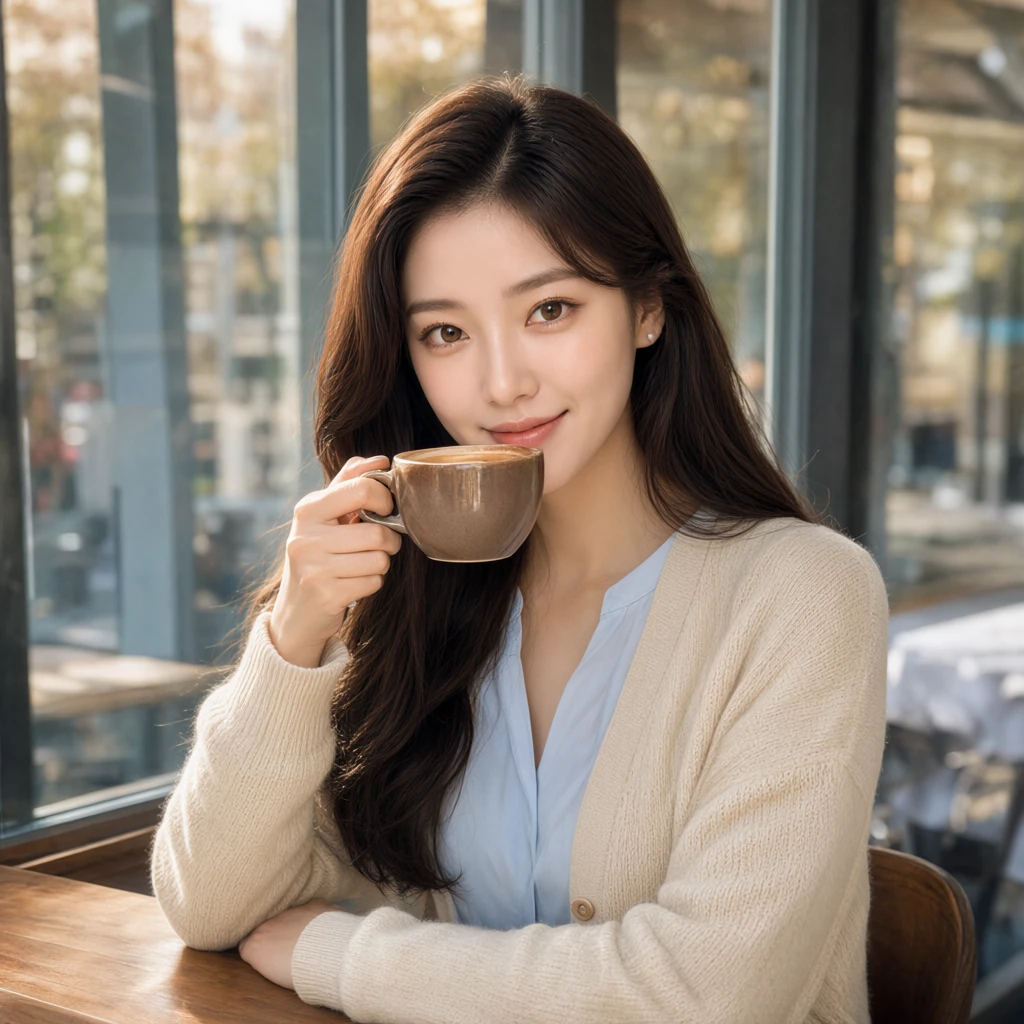
자연광이 들어오는 카페에서 커피를 마시는 일상적인 장면.
이번에는 반대로 스타일을 거의 걷어내고 평범한 일상 장면으로 바꿨다.
카페에서 커피를 들고 있는 자연스러운 포즈까지 새로 만들어졌고, 의상도 가벼운 카디건과 블라우스로 바뀌었다. 화려한 배경이나 장비가 없는 장면에서도 캐릭터 인상이 유지되는 걸 확인하기 좋았다.
판타지 여전사
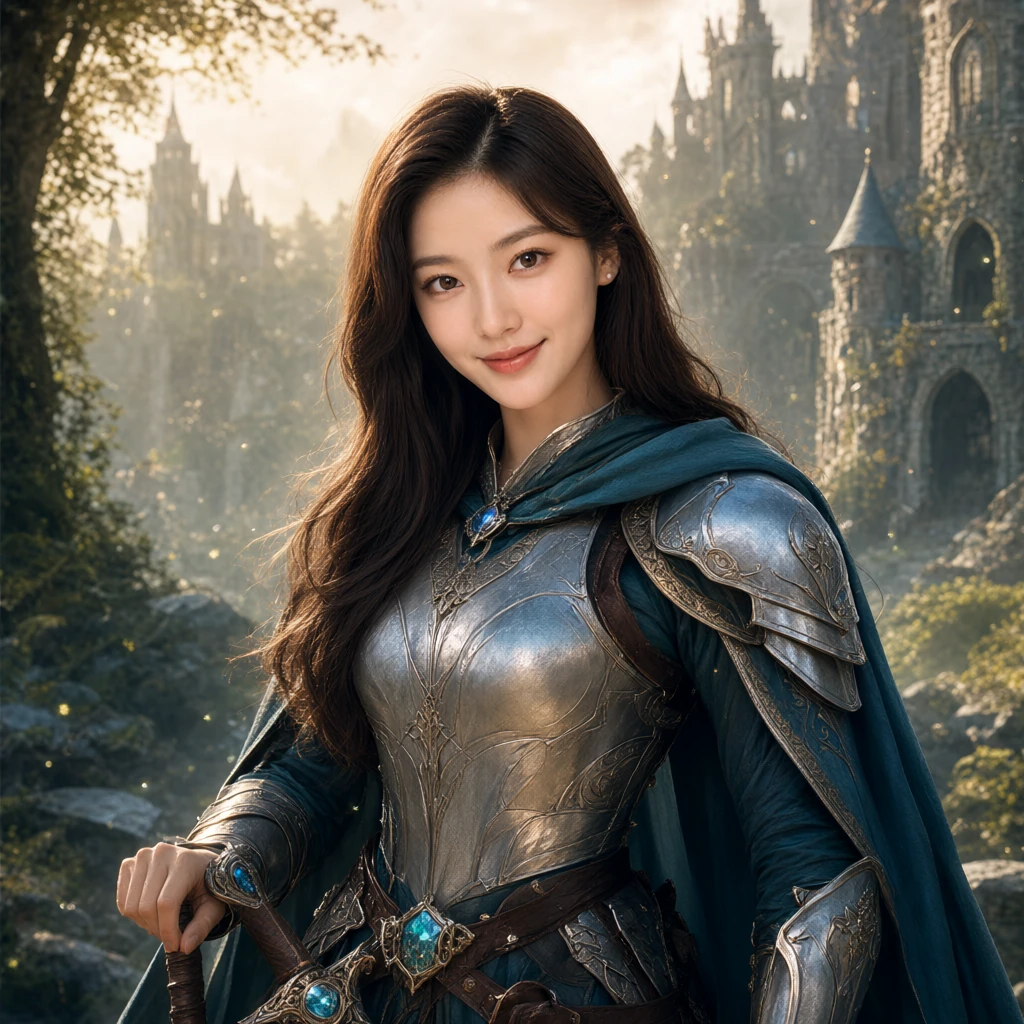
금속 갑옷과 망토, 고성 배경을 적용한 판타지 버전.
금속 갑옷과 망토, 검, 고성 배경을 넣어 판타지 여전사로 바꿔봤다.
의상과 세계관이 완전히 달라졌지만 얼굴 쪽은 기준 이미지의 특징을 계속 가져간다. 갑옷의 금속 질감이나 장식도 꽤 그럴듯하게 표현됐다.
이상한 나라의 앨리스 풍
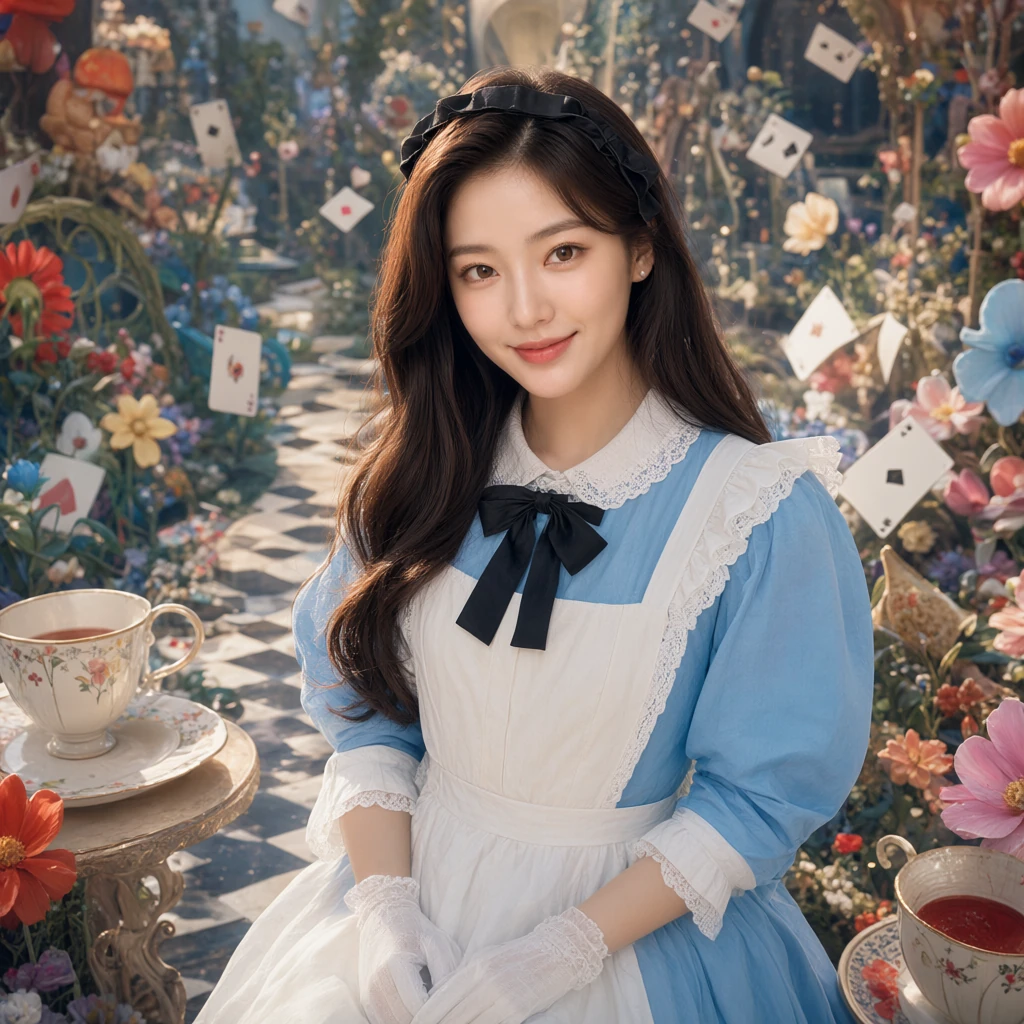
카드와 꽃, 티파티 요소를 넣어 동화적인 세계관으로 바꾼 장면.
이번에는 동화 쪽으로 더 크게 틀었다.
파란 드레스와 앞치마, 리본, 꽃과 카드가 떠다니는 배경까지 넣으니 원본과는 전혀 다른 장면이 됐다. 그래도 캐릭터의 얼굴과 전체적인 인상은 유지됐다.
모던 룩북
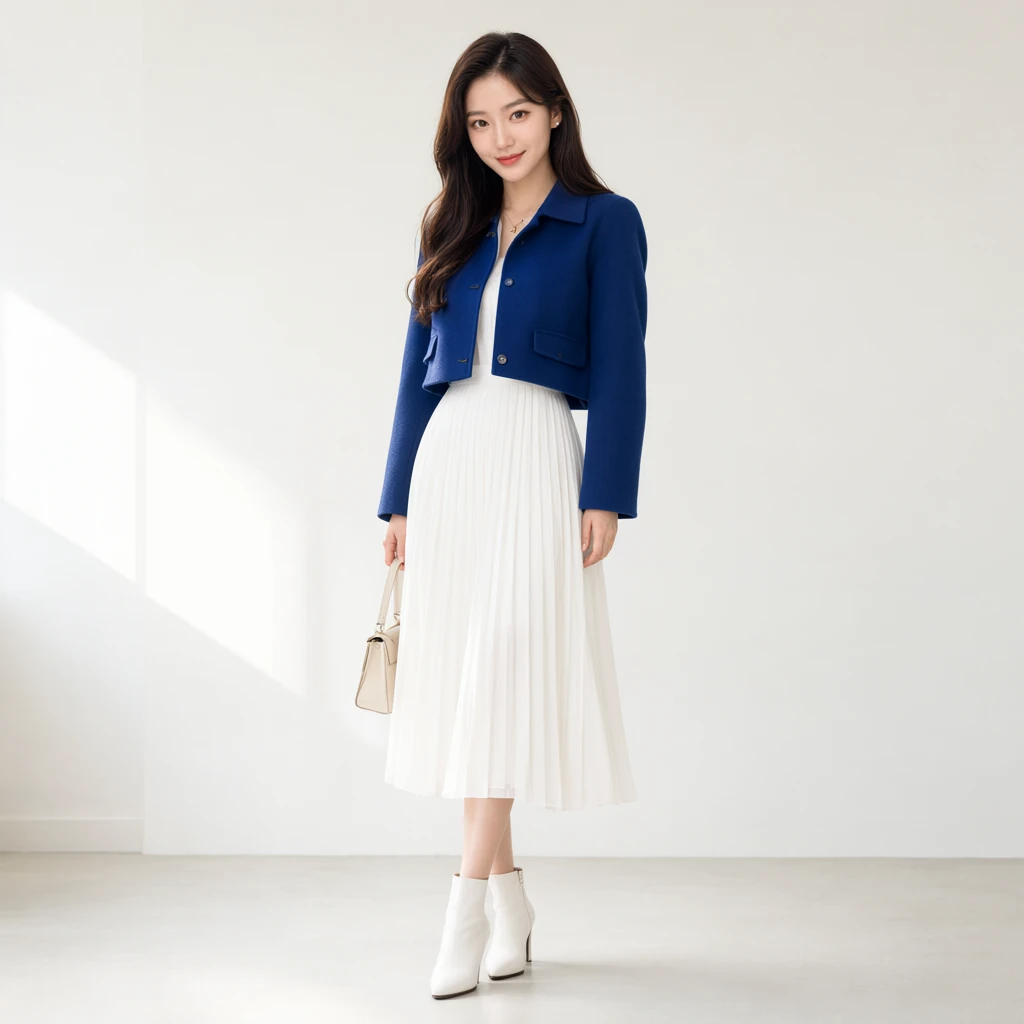
블루 재킷과 화이트 플리츠 드레스를 입힌 전신 패션 룩북.
마지막으로 전신 패션 룩북 스타일로도 만들어봤다.
블루 재킷, 화이트 플리츠 드레스, 부츠와 핸드백까지 전체 착장을 새로 구성했는데, 전신 구도에서도 얼굴 인상이 크게 무너지지 않았다.
한 장의 프로필 이미지만 가지고 이 정도로 서로 다른 분위기의 이미지를 연속해서 만들 수 있다는 점이 이번 테스트에서 가장 마음에 들었다.
여러 스타일을 바꿔도 캐릭터가 계속 남는다
샘플을 한꺼번에 놓고 보니 Qwen-Image 2.1의 장점이 더 잘 보였다.
사이버틱 에이전트, 판타지 여전사처럼 의상과 세계관을 크게 바꾸거나, 반대로 카페처럼 평범한 일상 장면으로 옮겨도 기본 캐릭터의 얼굴과 헤어, 전체적인 인상은 계속 이어졌다.
특히 별도의 LoRA를 만들거나 캐릭터 학습을 다시 하지 않고, 레퍼런스 한 장만 넣은 상태에서 이 정도 결과가 나온다는 점이 편했다.
GPT Image에서 자주 하던 방식처럼 기본 캐릭터 이미지를 하나 만들어두고,
“이 인물을 유지한 채 이런 장면으로 바꿔줘.”
라는 흐름을 로컬에서도 꽤 자연스럽게 가져갈 수 있었다.
이번에 사용한 건 레퍼런스 1장뿐이다. Qwen-Image 2.1은 최대 10장의 레퍼런스 이미지 입력과 RGBA 투명 배경 출력 같은 기능도 지원하지만, 이번에는 여기까지 사용하지 않았다.
정리
Qwen-Image 2.1은 유튜브에서 우연히 발견하고 바로 설치해본 신모델이었다.
처음에는 새 버전 하나 나온 정도로 생각했는데, 모델 카드를 보고 실제로 돌려보니 생각보다 훨씬 재미있는 모델이었다.
INT8 중심 구성은 GB10에서 부담 없이 돌아갔고, 1024×1024 편집은 약 28초, 9:16 전신 이미지는 약 30초 정도 걸렸다.
무엇보다 레퍼런스 기반 인물 편집이 마음에 들었다.
기준 이미지 한 장만으로 사이버틱 에이전트, 카페의 일상 장면, 판타지 여전사, 동화풍 세계관, 패션 룩북까지 바꿔봤는데도 같은 캐릭터라는 느낌이 계속 유지됐다.
간편하게 GPT Image에서 하던 레퍼런스 편집 흐름을 로컬에서 흉내낼 수 있는 모델이 나온 것 같다.
새 모델이 나오면 일단 설치하고 돌려보는 편인데, 이번에는 테스트가 끝난 뒤에도 몇 장 더 만들어보고 싶어졌다.
그 정도면 첫인상은 충분히 좋다.