LTX-2.5 비디오·월드 모델
개요
22B asymmetric dual-stream DiT, Diffusion Fidelity Rendering + Gemma 4 12B 인코더 + 네이티브 멀티샷 + 자동 길이 (2026-08-11 릴리즈)
메모
오픈웨이트, $10M ARR 미만 무료, 한국 제한 없음 (MiniMax H3와 대비). 2x GB200 720p 10초=6.8초 (벤더 측정). ComfyUI 0.32.0 필수 — 로컬 GB10은 int8 구성 ~40GB로 수용 가능, NVIDIA가 DGX Spark 로컬 추론 명시 최적화. 커뮤니티 GGUF 있음 (Abiray dev/distilled Q3~Q8, 9.7~23.6GB) — 단 인코더(Gemma4-12B with proj) GGUF는 미출시. 표준 워크플로우 = Comfy-Org 템플릿 3종(T2V·I2V·FLF2V) + Lightricks 공식 커스텀노드. ✅ GB10 실측 완료 (2026-08-14): 사장님 제작 I2V 2패스 워크플로우(nvfp4 distilled) — 5초 클립 1분 45초 (로딩 포함), 16:9 1280x704, 동기화 오디오 생성 확인, 테스트 영상·이미지 블로그 첨부 (드라이브 재생)
조사 상세
LTX-2.5 (Lightricks/LTX)
조사일: 2026-08-12 · 출처: ltx.io 공식, ComfyUI 블로그, VentureBeat/TL Dev Tech/MarkTechPost, HuggingFace, GitHub
개요
- 2026-08-11 릴리즈 — 오픈웨이트 비디오 + 오디오 + 월드 시뮬레이션 모델
- 아키텍처: 22B 파라미터 asymmetric dual-stream diffusion transformer (LTX-2/2.3과 동일한 22B급)
- 주요 변화: Diffusion Fidelity Rendering(신규 렌더링 방식) + diffusion video decoder(기존 VAE 디코딩 대체) + Gemma 4 12B 텍스트 인코더 + 프롬프트 인핸서 + 자동 길이(duration head) + 개선된 distilled 변형
- 4K·HDR·RAW, 동기화 오디오, 최대 50fps는 2.3에서 계승
- 모델군 누적 다운로드 3,300만+ (LTX 주장, 가장 많이 쓰인 오픈 월드모델 라인)
신기능 상세
- Diffusion Fidelity Rendering — 장면 복잡도에 따라 렌더링 컴퓨트 배분. 모션·구성·프레이밍을 8x 시간압축 latent로 먼저 생성하고 고품질 키프레임을 복잡도에 따라 배분, 전용 pixel-diffusion 스테이지가 최종 영상 렌더링. 텍스처·얼굴·복잡한 객체의 픽셀 정밀도 향상
- Diffusion Video Decoder — 기존 VAE 디코딩 대체. 빠른 모션에서 얼굴 선명도·텍스트 가독성·스미어 감소
- Gemma 4 12B 커스텀 텍스트 인코더 — 긴 프롬프트에서 다중 주체·동작·조명·카메라 지시 유지 (기존 인코더는 복잡한 프롬프트에서 조항 누락)
- 네이티브 멀티샷 — 한 번의 생성으로 연결된 여러 컷 생성, 캐릭터·환경·조명·음성 일관성 유지 (기존: 개별 생성 후 이어붙이기)
- 자동 길이 예측 — duration head 모델이 프롬프트의 동작을 읽고 클립 길이 자동 결정 (
model_patches/ltx-2.5-duration-head-bf16.safetensors, 실험적) - 개선된 distilled 모델 — NVIDIA와 공동 최적화, RTX GPU 로컬 실행 VRAM 절감. 4-8스텝 생성
- 파인튜닝용 base checkpoint — 물리 AI/로보틱스용 pretrained 체크포인트 포함 (도메인 파인튜닝 가능)
속도 벤치 (전부 벤더 측정, 독립 검증 아님)
| 항목 | 수치 |
|---|---|
| 2x NVIDIA GB200 셀프호스트 (720p, i2v 10초) | 6.8초 (실시간보다 빠름) |
| LTX API (1080p, 10초) | 23.7초 |
| Gemini Omni Flash | 52초 |
| Grok 1.5 | 63초 |
| Veo 3.1 (8초 클립 기준) | 70초 |
| MiniMax H3 | 180초 |
| Seedance 2.5 | 317초 |
| Kling 3.0 Pro | 398초 |
- 시각 아티팩트 점수(낮을수록 좋음, t2v 98프롬프트 자동 채점): LTX 2.5 Pro 0.28 / Fast 0.39 / FLUX 3 0.45 / MiniMax 0.46 / Wan 2.6 0.65 / Seedance 2.5 0.69 / LTX 2.3 Pro 0.74 / Kling 3 Pro 0.76 / Veo 3.1 1.20
- 블라인드 선호도 테스트에서도 1위 주장 (preliminary)
- 비용 주장: 비교 모델 대비 약 1/8 비용, 1/7 렌더 타임 (최소 16GB VRAM, Mac까지 지원)
모델 파일 (HF: Lightricks/LTX-2.5 — gated: auto, HF 계정 + 라이선스 동의 필요)
| 파일 | 크기 |
|---|---|
| dev transformer bf16 | 42.0 GB |
| dev transformer comfy-int8-convrot | 21.5 GB |
| distilled transformer bf16 | 42.0 GB |
| distilled transformer comfy-int8-convrot | 21.5 GB |
| distilled transformer nvfp4 | 18.7 GB |
| text encoder gemma4-12b with proj bf16 | 26.3 GB |
| text encoder gemma4-12b int8-convrot | 15.4 GB |
| video VAE bf16 (+conv 버전) | 1.5 GB ×2 |
| audio VAE bf16 | 0.4 GB |
| latent spatial upscaler x2 | 1.0 GB |
| latent temporal upscaler x2 | 0.3 GB |
| distilled LoRA (450) | 8.9 GB |
| duration head | 소량 |
- 전부 받으면 ~200GB. ComfyUI 실사용 최소 구성 ≈ 40GB (int8 트랜스포머 21.5 + int8 TE 15.4 + VAE 2 + 선택 업스케일러 1.3)
- GitHub Lightricks/LTX-2 v1.2.0 (2026-08-11): LTX 2.5 추론/학습 지원 — Gemma 4 인코더, diffusion VAE 디코딩(단일/멀티 GPU, NATTEN 가속), chunked_eager/compile
라이선스 (LTX-2.x Community License)
- 오픈웨이트, 의무 브랜딩 없음, 연매출 $10M 미만 무료 (이상은 협상 라이선스)
- 한국 제한 없음 — 공식 비교표에서 LTX는 전 지역 "Available"
- 파인튜닝·자가 데이터/IP 사용 가능
ComfyUI (Day-0 지원)
- ComfyUI 0.32.0 이상 필요 (로컬 2026-08-12 기준 v0.29.0-63 — 업데이트 필요)
- 템플릿: T2V / I2V / FLF2V (Templates 패널 또는 블로그에서 다운로드)
- 변형: open weights (dev, distilled) + Partner Nodes 호스팅 (Fast: 2-20초, 720p~4K, 24·25·48·50fps · Pro: 2-10초, 720p·1080p, 24·25·50fps)
- 공식 ComfyUI-LTXVideo 커스텀노드(선택): Gemma API 인코딩 노드(무료·1초), LTXVSave/LoadConditioning(프롬프트 인코딩 재사용)
품질 설정 가이드 (ltx.io 공식 워크플로우 가이드)
- CFG 3.0-3.5 기본 (2.0-5.0 범위), I2V는 3.0에서 시작
- distilled: 4-8스텝 (manual sigma schedule) / dev: 20-50스텝, 50 기본, I2V는 60-80
- 16:9 비율 필수 (정방/세로는 왜곡), 해상도는 타겟 그대로 생성 (업스케일보다 원본 생성)
- Multimodal Guider: 프롬프트 순응도 / 크로스모달 sync 별도 조절 — 지터링이면 sync↑, 프롬프트 무시면 순응도↑ (둘 다 맥스 금지)
- I2V 프롬프트는 "장면"이 아니라 "모션"을 서술 (LTX-2.3 가이드와 동일 원칙, 1-2개 액션 제한)
GGUF 양자화 모델 (커뮤니티, 2026-08-12 확인)
릴리즈 하루 만에 커뮤니티 GGUF 퀀트가 나옴. ComfyUI-GGUF 노드로 로드.
dev GGUF — Abiray/LTX-2.5-GGUF (2026-08-11)
| 퀀트 | 크기 |
|---|---|
| Q3_K_S / Q3_K_M | 9.7 / 10.6 GB |
| Q4_K_S / Q4_K_M | 13.0 / 14.2 GB |
| Q5_K_S / Q5_K_M | 15.0 / 15.9 GB |
| Q6_K / Q8_0 | 17.8 / 22.8 GB |
distilled GGUF — Abiray/LTX-2.5-Distilled-GGUF (2026-08-12)
- Q3_K_M 11.5 / Q4_K_S 13.9 / Q4_K_M 15.1 / Q5_K_M 16.8 / Q6_K 18.7 / Q8_0 23.6 GB
- GGUF용 공식 스타일 워크플로우 json 동봉:
video_ltx2_5_t2v_GGUF.json,video_ltx2_5_i2v_GGUF.json+ 샘플 mp4
기타
- realrebelai/LTX-2.5_GGUFs — distilled Q2_K~Q8_0 (Q2_K 추가)
- QuantStack/LTX-2.5-GGUF, vantagewithai/LTX-2.5-GGUF — 파일 업로드 전/소량
- ChrisColeTech/LTX-2.5-turbo-GGUF — 트랜스포머 없이 VAE·업스케일러만 (실사용 불가)
⚠️ 인코더 GGUF — 현재 없음
- LTX-2.5 텍스트 인코더(gemma4-12b-with-proj) GGUF는 2026-08-12 기준 미출시 (HF 검색 + city96 미지원 확인)
- 기존 gemma4-12B GGUF(unsloth/bartowski 등)는 일반 LLM용으로 projection 레이어가 없어 LTX-2.5에 그대로 못 씀
- 인코더는 공식 int8-convrot (15.4GB) 또는 bf16 (26.3GB) 사용 → GGUF는 트랜스포머만 해당
표준 워크플로우 (공식 링크)
| 워크플로우 | 링크 |
|---|---|
| T2V 공식 템플릿 | https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_ltx2_5_t2v.json |
| I2V 공식 템플릿 | https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_ltx2_5_i2v.json |
| FLF2V 공식 템플릿 | https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_ltx2_5_flf2v.json |
| ComfyUI 내장 | 0.32.0 Templates 패널에서 로드 (또는 blog.comfy.org 게시글에서 다운로드) |
| 공식 안내 페이지 | https://comfy.org/ltx-2.5 |
| Lightricks 공식 커스텀노드 | https://github.com/Lightricks/ComfyUI-LTXVideo (⭐4K, 2026-08-12 갱신) |
| 공식 워크플로우 가이드 | https://ltx.io/blog/comfyui-workflow-guide |
| GGUF용 워크플로우 | Abiray distilled 리포 내 video_ltx2_5_t2v_GGUF.json / video_ltx2_5_i2v_GGUF.json |
| LoRA·업스케일 커뮤니티 | https://ltx.io (Community Library) |
DGX Spark GB10 적용 분석
- 현재: LTX 2.3 22B fp8 (29GB) → 10초 클립 112-150초/개
- LTX-2.5 권장 조합: int8 트랜스포머 (21.5GB) + int8 TE (15.4GB) + VAE ≈ 40GB — 128GB unified 메모리에 여유 있게 수용, 기존 free_memory 순서(이미지→언로드→영상→언로드) 그대로 적용 가능
- GGUF 대안 (저메모리): dev Q4_K_M 14.2GB 또는 distilled Q4_K_M 15.1GB — ComfyUI-GGUF 노드로 로드, 인코더는 int8 필수 (GGUF 미출시)
- nvfp4 (18.7GB)는 Blackwell FP4 네이티브 — GB10도 지원 계열, 최소 메모리 옵션
- MarkTechPost: "NVIDIA가 RTX GPU와 DGX Spark 로컬 추론 최적화, VRAM 요구 절감" 명시 — GB10 공식 타깃 하드웨어
- ⚠️ GB10 실측 벤치는 아직 없음 (릴리즈 하루차). distilled 4-8스텝 구조라 2.3 대비 빨라질 것으로 예상되나 수치 확인 전까지는 추정 금지
- ⚠️ HF gated라 다운로드 전 HF 계정 로그인 + 라이선스 동의 필요 (기존 모델 다운로드와 다른 절차)
GB10 실측 테스트 (2026-08-14) — nvfp4 distilled I2V 2패스 워크플로우
- 사장님 제작 API 워크플로우:
tools·comfy_workflows·video_ltx2_5_i2v_api.json— 1패스(640x360, 8스텝 euler_ancestral, 시드 고정) → spatial upscaler x2 → 2패스 refine(1280x720, 4스텝, 시드 42) + 오디오 VAE 동시 생성 - 모델: nvfp4 distilled (18.7GB) + gemma4-12b int8 TE (15.4GB) + video/audio VAE — 총 ~35GB (128GB unified에 여유, free_memory 불필요)
- 결과: 5초 클립 (5.04s, 24fps, 121프레임) — 모델 로딩 포함 1분 45초 (LTX 2.3 10초 112-150초 대비 획기적 개선)
- ⚠️ Width/Height는 시작 이미지 크기로 매칭 필수 (사장님 지적 2026-08-14) — 1차 실행이 9:16 세로(720x1280 설정)로 잘못 나감 → 이미지(1280x720)에 맞춰 재실행: 1280x704 (16:9) 정상 출력, 움직임 25.6/37.3, 오디오 max -12.3dB
- 오디오 생성 확인: aac 2ch, max -12.3dB (실신호) — 동기화 오디오 동작
- 검증: 프레임 간 픽셀 변화 19.6·22.5 (정상 애니메이션), 파일
tools·ComfyUI·output·video·LTX-2.5_i2v_00002_.mp4
GB10 실측 2차 — SF 단편 영화 'THE SIGNAL' 60초 (2026-08-16, Krea2 + LTX 2.5)
- 운영 검토: LTX 2.5로 60초 SF 영화 — Krea2 이미지 → 5~10초 클립 → 영어 대사 + 1280×720
- 방식: 6씬 × 10초. 씬별 Krea2 이미지(1280×720, ~20초/장) → LTX 2.5 i2v(10초) → ffmpeg xfade 0.5s 크로스페이드(오디오 acrossfade 포함) → 57.7초 완성본
- 실측: 10초 1280×720 클립 ≈ 2~3분/개 (첫 클립 모델 로드 포함 ~3.5분), 6클립 전체 ~19분. 워크플로우 노드: 프롬프트
398:376(value), Width398:372, Height398:360, Duration398:362(5→10) - 영어 대사 발화 성공:
speaks clearly in English, "..."프롬프트 → 오디오 VAE가 대사+효과음 동시 생성 (aac) — 립싱크 포함 - 시선 수정 사례: 씬3 AI가 커맨더를 안 보고 말함 → 프롬프트에
fixes its glowing eyes directly on her face and holds her gaze+its eyes never leave her face→ 시선 고정 재생성 성공 - ⚠️ xfade 함정: 크로스페이드 재인코딩 시 출력이 yuv444p로 바뀌어 텔레그램/모바일 재생 불가 →
-pix_fmt yuv420p -movflags +faststart필수 (ltx-image-video-on-demand 스킬에 기록) - 사장님 평가: "재미있네", "LTX 2.5 땟깔이 좋다" — 2.3 대비 화질/질감 만족
- 산출물: `[로컬] — make_sf_movie.py(재사용 가능), THE_SIGNAL_60s_v3.mp4 (21MB)
테스트 결과 미디어 (2026-08-14, GB10 로컬 생성 — 블로그 공개용)
- 시작 이미지 (클레이 토끼, Krea 생성):
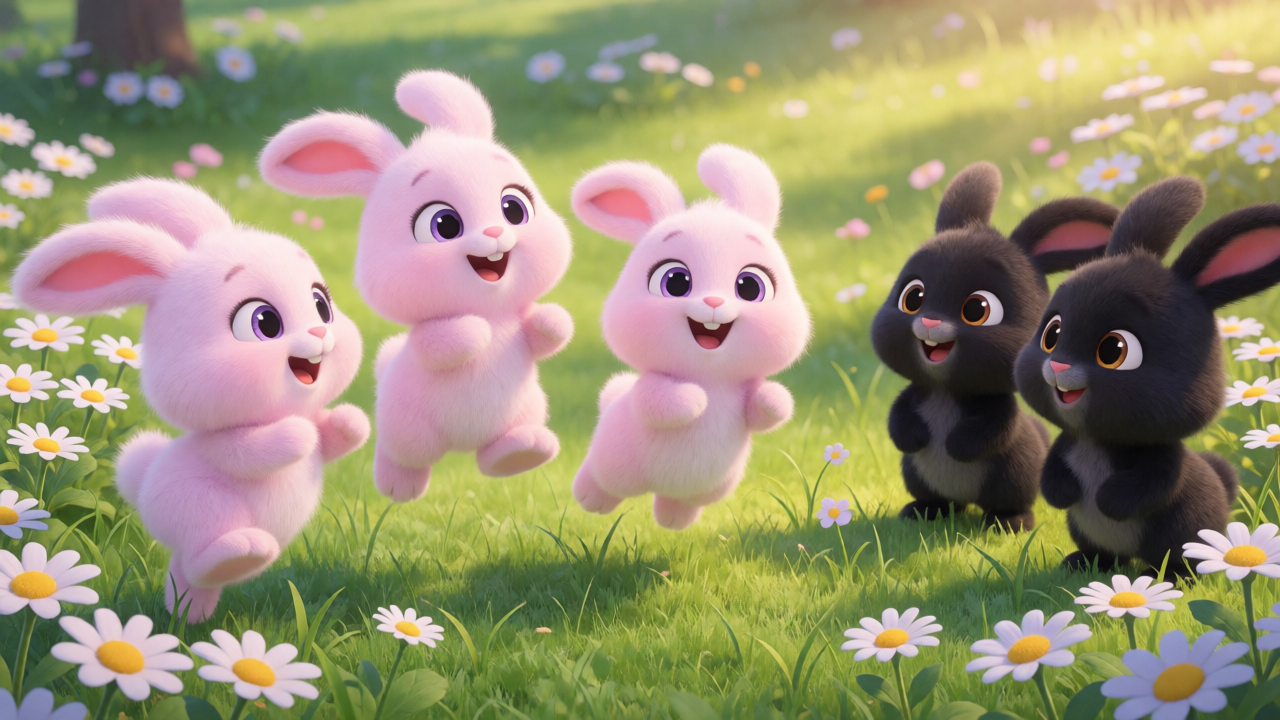
- 16:9 생성 영상 (1280x704, 5초, 24fps, 사운드 포함):
- 9:16 세로 버전 (비교용, 704x1280):
후속 제안 (진행 상태)
- ~~ComfyUI git pull → v0.32.0~~ ✅ 완료 (2026-08-12, v0.32.0-5)
- ~~HF 인증 후 모델 다운로드 (~40GB)~~ ✅ 완료 — nvfp4 distilled + int8 TE + VAE 2종 + spatial upscaler
- ~~LTX-2.5 템플릿으로 10초 테스트~~ 🔄 5초 테스트 완료 (2026-08-14) — 2.3 대비 품질/속도 비교 후 파이프라인 적용 여부 결정 대기
- 멀티샷(연속 컷) + 자동 길이 기능은 YouTube 파이프라인에 활용 가능성 있음 (미테스트)
- ~~드라이브 영상 재생 방법 조사~~ ✅ 해결 (2026-08-14, 2단계 실측):
- 1차 시도 export=view(inline+206)는 curl에서만 성공 — 브라우저 video 태그는 sec-fetch-dest: video 요청에 드라이브가 403 → Chrome ORB(net::ERR_BLOCKED_BY_ORB)가 차단 (구글이 드라이브 UI 밖 직접 스트리밍 원천 차단)
- 최종: Vercel 서버리스 프록시 (api·drive 라우트 — devsnack-blog 소스의 src·app·api·drive·route.ts) — 서버 fetch(403 안 걸림) → same-origin + inline + Range 전달 → 브라우저 정상 재생 실측 (currentTime 2.41s/5.04s, paused=False)
- ltx-2-5.md 영상 2개를 프록시 URL로 교체 완료
- 재사용 방법: — 드라이브 미디어 → Vercel 재생 표준 절차
2026-08-20 갱신 — GPT Image 2 기준 이미지 + LTX 2.5 native audio 숏 무비
기존 LTX-2.5 기록은 Krea 2로 장면 이미지를 만들고 LTX I2V를 연결하는 흐름에 집중했다. 이 방식은 장면별 생성 자유도는 높지만, 인물 얼굴·헤어·의상이 장면마다 달라지는 문제가 있었다. 최신 실험에서는 이미지 생성과 영상 생성을 분리한다.
GPT Image 2 Medium
 → 2×2 character reference sheet
 → same reference image for every scene
 → 16:9 scene stills with all required subjects in frame
 → resize/verify actual files to 1280×720
 → LTX-2.5 2-pass I2V + native audio/dialogue
 → xfade/acrossfade + yuv420p/faststart final MP4
새로 확인한 운영 원칙
- GPT Image의 일관성은 보장이 아니라 통제 문제 — 공식 문서도 반복 캐릭터·브랜드 요소의 일관성이 가끔 무너질 수 있다고 안내한다. 기준 시트와 참조 이미지 입력을 사용하고, 장면별 검수·재생성을 필수 단계로 둔다.
- 실제 파일 해상도 검증 — 이번 GPT Image 실행 결과는 도구 메타데이터의
1536×1024와 달리 로컬 PNG가1672×941로 확인됐다. 모델 응답 메타데이터보다file[경로] 실측을 우선한다. - LTX 입력 해상도 일치 — GPT Image 결과를 1280×720으로 정규화하고, 워크플로의 Width/Height도 1280/720으로 주입한다. LTX 출력은 32배수 라운딩 때문에 1280×704가 될 수 있다.
- 프롬프트 인핸서 선택 제어 — 한국어 대사·시선·동작 순서를 재현해야 하는 장면에서는
398:383=false로 자동 보강을 끄고 직접 작성한 원문 프롬프트를 우선한다. - 이미지와 영상 프롬프트 분리 — 이미지에는 프레임에 존재해야 할 인물·괴물·유물·방패를 배치하고, I2V 프롬프트에는 움직임·카메라·대사만 집중한다.
- LTX native audio 우선 검증 — 기존 기록에서 영어 대사·오디오 VAE가 성공했으므로, 이번에는
speaks clearly in Korean: "..."형식으로 한국어 대사까지 직접 검증한다. 불안정할 때만 Qwen3-TTS를 fallback으로 사용한다. - 장면당 지배 이벤트 하나 — 10초 클립에 여러 전환을 넣지 않고, 포털 발견·흡입·유물 발견·마법 선택·방패 방어·포털 폐쇄처럼 하나의 핵심 행동을 지정한다.
이번 프로젝트 블루프린트
- 프로젝트:
isekai-instagram-mage-prologue - 콘셉트: 이세계에 간 한국 인스타 여신이 마법사가 되다 — 프롤로그
- 구성: 6장면 × 10초, 0.45초 크로스페이드, 약 57.75초
- 이미지: GPT Image 2 Medium, 동일 캐릭터 시트 참조
- 영상: LTX 2.5 distilled NVFP4, 2-pass I2V
- 오디오: LTX 2.5 native audio, 장면별 한국어 대사·환경음
- 산출물·프롬프트: `[로컬]
- 상세 페이지:
1회차 실제 결과 — 생성 성공, identity 보존 실패
2026-08-20에 6개 장면을 모두 생성하고 최종 MP4까지 합성했다.
- 채택된 6개 클립 생성 시간: 1125.513초 / 18.76분
- Scene 1 첫 시도 폐기분 포함 전체 LTX 생성 시간: 약 1346.223초 / 22.44분
- 클립별 길이: 각 10.041667초
- 클립 출력: 1280×704, 24fps, H.264, yuv420p, AAC 48kHz stereo
- 최종 출력: 58초, 1280×704, H.264 NVENC, yuv420p, AAC, 24.82MB
개별 장면 프레임은 해부학적으로 대체로 사용 가능했다. 그러나 캐릭터 기준 시트와 6개 영상의 중간 프레임을 한 장의 비교 시트로 묶어 다시 보자, 장면 중간부터 얼굴 identity가 달라졌다. 여성·긴 검은 머리·분위기는 유지됐지만 눈 간격, 코·입 비율, 턱선과 얼굴 세로 비율이 바뀌어 “같은 인물”로 보기 어려운 장면이 있었다.
이전 검수는 “프레임이 자연스러운가?”에는 답했지만 “기준 시트와 같은 사람인가?”를 별도 gate로 묻지 않았다. 따라서 이 결과는 모델의 영상 생성 실패이면서 동시에 검증 프로토콜의 실패다. Scene 5의 뒷모습, Scene 6의 얼굴 가림처럼 얼굴이 충분히 보이지 않는 장면은 identity 미검증으로 표시해야 한다.
후속 비교 계획
distilled 모델이나 빠른 추론용 LoRA·양자화 경로가 identity 보존에 불리했을 가능성은 있지만, 이번 결과만으로 원인을 단정하지 않는다. GPT Image 장면 이미지 차이, I2V 전환, 2-pass refine, 프롬프트 복잡도도 함께 영향을 줄 수 있다.
GB10에서는 steps를 높이면 생성 시간이 크게 증가하므로 Scene 1·3·4처럼 얼굴이 잘 보이는 2~3개 장면만 골라 distilled/base 모델과 steps 차이를 비교한다.
링크
- 공식: https://ltx.io/model/ltx-2-5 · HF: https://huggingface.co/Lightricks/LTX-2.5 · GitHub: https://github.com/Lightricks/LTX-2
- ComfyUI 블로그: https://blog.comfy.org/p/ltx-25-day-0-support-in-comfyui
- 워크플로우 가이드: https://ltx.io/blog/comfyui-workflow-guide
- OpenAI Image Generation: https://developers.openai.com/api/docs/guides/image-generation
- Comfy-Org LTX-2.5 I2V Workflow: https://github.com/Comfy-Org/workflow_templates/blob/main/templates/video_ltx2_5_i2v.json