RTX 5090 전용 NInfer를 DGX Spark GB10에 포팅해봤다 — 27B는 졌고, 35B MoE는 달랐다
Qwen3.5 계열 Dense/MoE 모델에 특화된 C++/CUDA 기반 추론 엔진 NInfer를 접했다.
llama.cpp나 vLLM처럼 범용성을 우선하는 엔진과 달리, NInfer는 특정 GPU와 모델을 목표로 CUDA Graph, 커스텀 양자화, MTP/DFlash, Paged KV Cache 같은 최적화를 밀도 있게 결합한 구조였다.
문제는 지원 환경이었다.
빌드 타깃은 사실상 RTX 5090의 sm_120a에 맞춰져 있었고, 코드 곳곳에는 5090의 170 SM을 기준으로 한 튜닝 값이 들어 있었다.
내가 테스트할 장비는 NVIDIA DGX Spark였다.
| 항목 | 환경 |
|---|---|
| Device / GPU | NVIDIA DGX Spark / GB10 |
| Compute Capability | 12.1 |
| SM | 48 |
| CPU Architecture | aarch64 |
| Unified Memory | 128GB LPDDR5X |
| Memory Bandwidth | 273 GB/s |
| Driver / CUDA | 580.178.04 / CUDA 13.0 |
| nvcc | 13.0.88 |
궁금했던 것은 단순했다.
RTX 5090에 강하게 최적화된 NInfer를 GB10으로 가져오면 실제 성능 이득까지 얻을 수 있을까?
결과부터 말하면 모델 구조에 따라 완전히 달랐다.
- 27B Dense: 정상 포팅에는 성공했지만 기존 llama.cpp 구성 대비 성능상 이점이 없었다.
- Qwen3.6-35B-A3B MoE: 같은 GB10에서도 결과가 크게 달라졌다. 긴 프롬프트 기준 Prefill은 약 3.3배, Non-spec Decode는 약 1.8배 빨랐고, MTP3 적용 시 98~111 tok/s를 기록했다.
다만 두 런타임은 사용하는 양자화 포맷도 다르다. 따라서 아래 결과는 순수한 커널 성능 비교라기보다 GB10에서 실제 사용할 수 있는 두 시스템 구성의 비교에 가깝다.
1. 첫 번째 문제는 "sm_121a"가 아니었다
가장 먼저 확인한 것은 GB10의 sm_121a에서 NInfer의 CUDA 코드를 빌드할 수 있는지였다.
일반 CUDA 커널은 다음과 같이 문제없이 컴파일됐다.
nvcc -arch=sm_121a
하지만 NInfer의 핵심 연산 중 하나인 NVFP4 mma.sync 코드를 분리해 테스트하자 오류가 발생했다.
Instruction 'mma with block scale' not supported on .target 'sm_121'
처음에는 GB10 자체가 해당 블록 스케일 명령을 지원하지 않는 것처럼 보였다.
그런데 같은 코드를 sm_120a 대상으로 빌드해도 동일한 오류가 발생했다.
원인은 GPU가 아니라 컴파일 플래그였다.
Virtual Architecture에도 a 접미사를 명확히 지정하도록 바꾸자 컴파일이 정상적으로 통과했다.
--generate-code=arch=compute_121a,code=[compute_121a,sm_121a]
즉, 최소한 이 단계에서 확인한 결과는 NVFP4 명령 자체가 GB10에서 막히는 것은 아니었다.
2. 빌드는 됐지만 런타임도 5090에 묶여 있었다
다음은 실제 NInfer 빌드였다.
CMakeLists.txt에서 sm_120a만 허용하던 제한을 풀고 121a를 추가했다.
cmake -S . -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES=121a

cmake --build build -j
총 437개 타깃이 정상 빌드됐고, cuobjdump에서도 바이너리가 sm_121a 대상으로 생성된 것을 확인했다.
하지만 첫 실행은 즉시 종료됐다.
시작 루틴에 Compute Capability를 12.0으로만 제한하는 런타임 체크가 하나 더 남아 있었다.
이 부분에 12.1을 허용하자 처음으로 모델 가중치가 GB10에 정상 로드됐다.
여기까지는 포팅 성공이었다.
문제는 성능이었다.
3. Qwen3.8-27B Dense: 포팅은 성공했지만 빨라지지 않았다
첫 번째 테스트 모델은 Qwen3.8-27B NVFP4, 가중치 크기 약 19GB였다.
MTP3와 LM Head Draft를 활성화했다.
--spec mtp --draft-tokens 3 --lm-head-draft
CUDA Graph와 MTP3 모두 정상적으로 동작했고, 추론 중 GPU 사용률은 약 95%, 클럭은 약 2.5GHz까지 올라갔다.
하지만 속도는 기대보다 낮았다.
- MTP3 Decode: 약 21.5 tok/s
- 짧은 요청 최대: 약 28 tok/s
- Non-spec Decode: 약 10.6 tok/s
Nsys 프로파일링을 해보니 전체 런타임의 90% 이상을 GEMM이 차지했다.
여기서는 코드보다 GB10의 메모리 대역폭이 더 큰 제약이었다.
NInfer NVFP4 가중치를 약 19.7GB로 보면 단순 계산상:
19.7 GB / 273 GB/s ≈ 72 ms
토큰마다 전체 가중치를 한 번 읽는다고 단순화하면 약 13.9 tok/s 수준의 대역폭 상한이 나온다.
실제 Non-spec Decode가 약 10.6 tok/s였다는 점을 보면, 커널 몇 개를 더 최적화한다고 상황이 크게 바뀔 가능성은 높지 않았다.
더 중요한 비교 대상도 있었다.
기존 llama.cpp 환경에서는 약 12.6GB의 Ridge 3.7bpw GGUF를 사용하고 있었고, MTP 적용 시 약 30 tok/s가 나왔다.
19.7GB NVFP4 가중치를 읽는 NInfer가 12.6GB GGUF와 같은 메모리 대역폭을 두고 경쟁하는 구조다.
결국 27B Dense에서는 NInfer를 GB10으로 포팅했다는 사실 자체는 의미가 있었지만, 실사용 성능 측면에서는 기존 llama.cpp + 경량 GGUF 구성을 바꿀 이유를 찾지 못했다.
4. Qwen3.6-35B-A3B MoE에서는 결과가 달라졌다
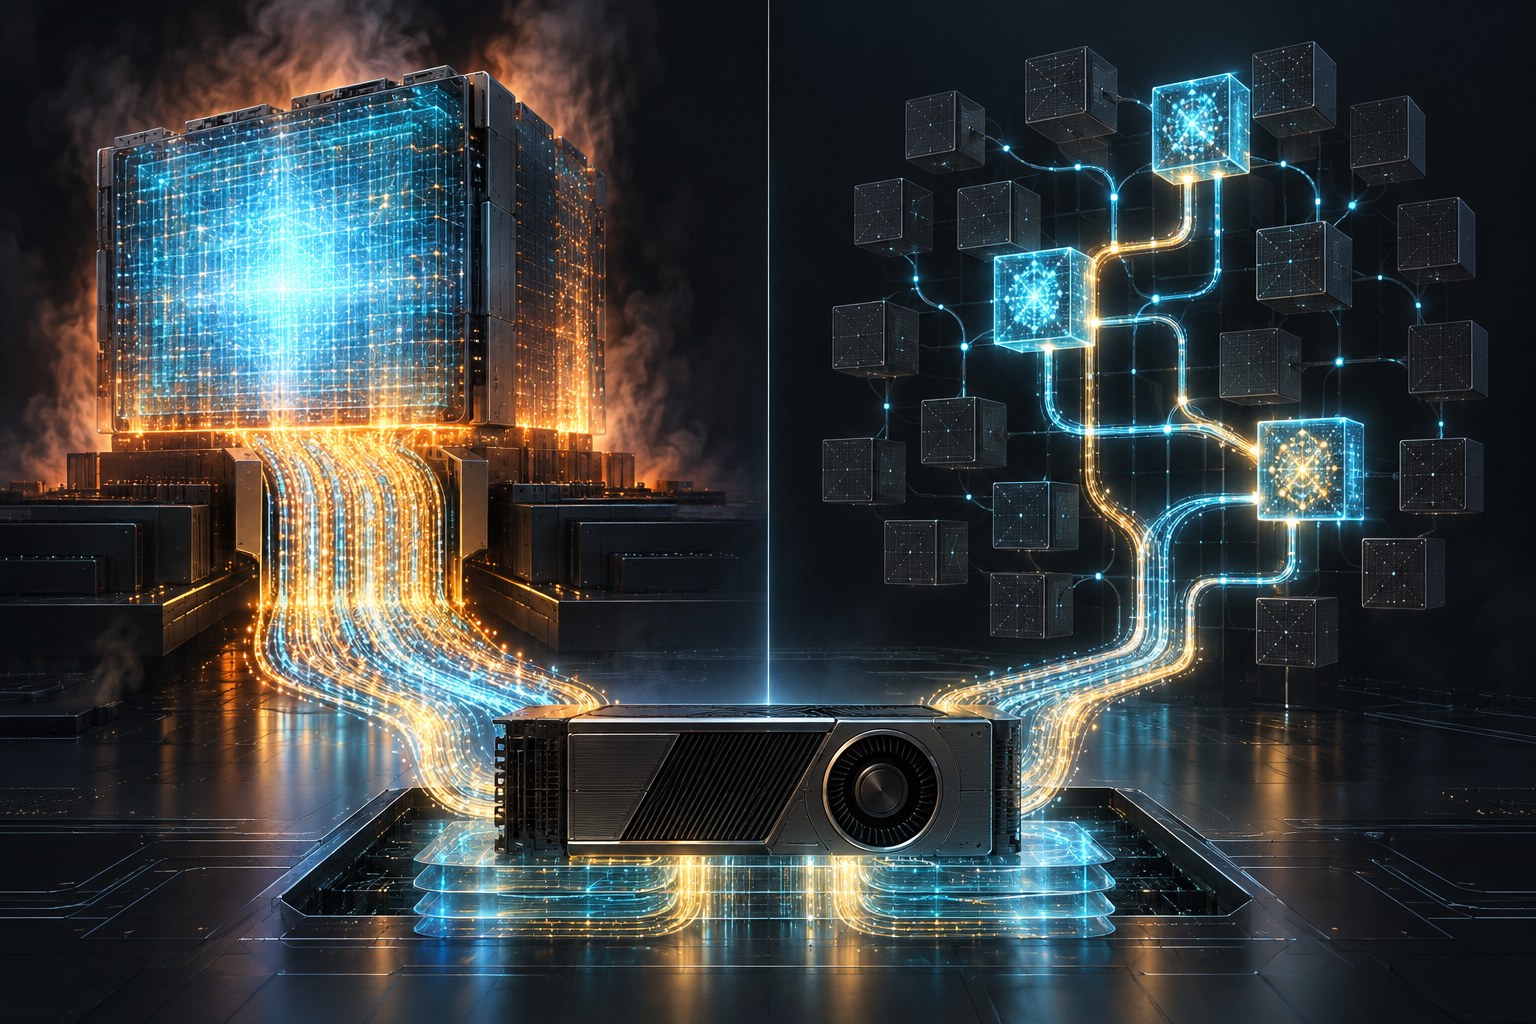
Dense 모델과 MoE 모델의 전체 경로 실행과 선택적 expert 라우팅을 비교한 개념 일러스트.
두 번째 테스트는 Qwen3.6-35B-A3B MoE였다.
Dense 모델과 달리 MoE는 매 토큰마다 전체 모델 파라미터를 동일하게 사용하는 구조가 아니다. 이 차이가 GB10에서는 꽤 크게 나타났다.
NInfer의 공식 groupwise-int 아티팩트에 MTP3를 적용했다.
결과는:
- MTP3 Decode: 98~111 tok/s
- MTP Acceptance: 46~56%
- Non-spec Decode: 약 65~69 tok/s
27B Dense 때와는 완전히 다른 범위의 속도였다.
이제 NInfer 포팅이 단순한 호환성 실험을 넘어 실제 사용할 만한 선택지가 되기 시작했다.
Prefill 300 tok/s의 정체
처음 측정한 Prefill은 약 300 tok/s에 불과했다.
하지만 NInfer 자체의 문제가 아니라 벤치마크 조건이 잘못된 것이었다.
측정에 사용한 입력이 약 65토큰뿐이어서 긴 프롬프트에서의 Prefill 처리량을 제대로 보여주지 못했다.
조건을 다시 맞춰 약 6,800토큰 프롬프트로 측정했다.
NInfer 기본 Prefill Chunk인 1024에서도 바로 4,350 tok/s가 나왔다.
여기에 GB10에 맞는 청크 크기를 탐색했다.
| Prefill Chunk Size | Throughput |
|---|---|
| 1024 — 기본값 | 4.35k tok/s |
| 2048 | 4.89k tok/s |
| 4096 | 5.31k tok/s |
| Full Prompt (~6912) | 5.21k tok/s |
4096에서 기본값 대비 약 22% 더 높은 처리량이 나왔다.
4096 청크가 요구하는 워크스페이스는 약 417MiB였다. 128GB Unified Memory를 가진 GB10에서는 부담이 크지 않다.
따라서 upstream 기본값 자체를 바꾸지는 않았지만, GB10에서는 --prefill-chunk 4096을 권장 설정으로 잡았다.
5. llama.cpp와 실사용 구성으로 비교
같은 약 6,810토큰 프롬프트를 넣고 GB10에서 실제 사용 가능한 두 구성을 비교했다.
- llama.cpp: Qwen3.6-35B-A3B Q8_0
- NInfer GB10 Port: Qwen3.6-35B-A3B groupwise-int
| 항목 | llama.cpp Q8_0 | NInfer groupwise-int | 차이 |
|---|---|---|---|
| Prefill | 1,612 tok/s | 5,310 tok/s | 약 3.29× |
| Decode — Non-spec | 36.8 tok/s | ~65 tok/s | 약 1.77× |
| Decode — MTP3 | - | 98~111 tok/s | 최대 약 3× |
이 숫자는 꽤 크지만 해석에는 주의가 필요하다.
두 엔진이 동일한 양자화 포맷으로 동일 커널만 비교된 것이 아니다.
따라서 이것을 단순히 “NInfer 엔진이 llama.cpp보다 3.3배 빠르다”고 해석하면 안 된다.
더 정확한 표현은 다음에 가깝다.
현재 GB10에서 실제로 구성할 수 있는 Qwen3.6-35B-A3B 실행 환경 중, 이번에 테스트한 NInfer groupwise-int 구성이 llama.cpp Q8_0 구성보다 Prefill과 Decode 모두 높은 처리량을 보였다.
6. 왜 Dense와 MoE의 결과가 달랐을까
GB10의 특징을 단순하게 보면:
- 128GB의 큰 Unified Memory
- 273 GB/s의 비교적 제한적인 메모리 대역폭
이다.
Dense 모델에서는 매 토큰 생성 시 읽어야 하는 가중치의 양이 크다.
이 경우 엔진 최적화 못지않게 가중치를 얼마나 작게 만들었는가가 중요해진다.
27B 테스트에서는:
- llama.cpp: 약 12.6GB, 3.7bpw GGUF
- NInfer: 약 19.7GB, NVFP4
였기 때문에 NInfer가 코드 레벨에서 빠른 경로를 가지고 있더라도 메모리 트래픽 차이를 상쇄하기 어려웠다.
반면 MoE에서는 매 스텝마다 사용되는 Expert가 제한된다.
따라서 Dense와는 메모리 접근 패턴과 실제 연산량이 달라지고, 그 조건에서는 NInfer가 가지고 있는 Sparse MoE 경로, CUDA Graph, MTP 등의 최적화가 효과를 낼 여지가 커진다.
이번 실험 결과는 그 차이가 GB10에서도 실제 처리량 차이로 이어질 수 있다는 것을 보여줬다.
다만 각각의 최적화가 성능 향상에 얼마나 기여했는지를 별도로 분리 측정한 것은 아니다.
7. 코드에 박혀 있던 170 SM도 걷어냈다
개념 이미지: 실제 GB10의 SM 배치나 하드웨어 토폴로지가 아니라 플랫폼 포팅과 launch tuning을 추상화한 삽화입니다.
빌드와 런타임 제한을 푸는 것만으로 끝나지는 않았다.
NInfer 코드에는 RTX 5090의 170 SM을 전제로 한 런치 튜닝 값들이 여러 곳에 존재했다.
GB10은 48 SM이다.
cudaGetDeviceProperties()를 이용해 실제 SM 수를 런타임에서 감지하는 헬퍼를 추가하고 다음 경로에 적용했다.
- GDN chunked output distribution
- small-T attention split cap
- Sparse MoE prefill grid cap
- RoPE wave threshold
170 SM GPU에서는 기존 upstream 계산과 동일하게 동작하도록 스케일링했다.
단일 배치 기준 성능 변화는 크지 않았다.
- Decode: 21.5 → 21.9 tok/s
- Prefill: 2.54k → 2.63k tok/s
오차 범위에 가까운 수준이다.
이 수정의 목적은 단일 벤치마크 숫자를 끌어올리는 것보다는, batch > 1이나 MoE Prefill처럼 GPU 전체에 작업을 분배해야 하는 상황에서 실제 하드웨어 토폴로지에 맞는 런치 구성을 사용하는 것이었다.
8. API 서버까지 확인
포팅한 ninfer-serve를 통해 OpenAI 호환 API 서버도 테스트했다.
확인한 항목은 다음과 같다.
- Thinking 태그 보존
- 동시 2개 세션 처리
- MTP 가속
- OpenAI 호환 API 요청/응답
모두 정상적으로 동작했다.
즉, 단순히 벤치마크 바이너리 하나가 GB10에서 실행되는 수준을 넘어 실제 로컬 API 서버로 사용할 수 있는 상태까지 확인했다.
정리
이번 실험에서 가장 재미있었던 점은 “NInfer가 GB10에서 동작하는가?”보다 “어떤 모델에서 의미가 생기는가?”였다.
27B Dense에서는 포팅에 성공했지만 기존 llama.cpp + 경량 GGUF 구성을 넘어설 이유를 찾지 못했다.
반면 Qwen3.6-35B-A3B MoE에서는 상황이 달랐다.
긴 프롬프트 기준으로 이번 테스트 구성에서는:
- Prefill: 1,612 → 5,310 tok/s
- Non-spec Decode: 36.8 → 약 65 tok/s
- MTP3 Decode: 98~111 tok/s
를 확인했다.
GB10에서 NInfer를 사용할 경우 --prefill-chunk 4096도 현재 테스트 기준으로 권장할 만했다.
포크는 아래 저장소에 공개했다.
GitHub: gdevsnack-ai-labs/ninfer-gb10
DGX Spark 기본 환경인 CUDA 13.0 / Driver 580.178에서 별도의 CUDA 13.1 업그레이드 없이 빌드하고 실행할 수 있다.
현재 포크는 experimental 상태다.
RTX 5090을 대상으로 한 upstream NInfer를 대체하려는 프로젝트가 아니라, upstream 동작을 최대한 유지하면서 DGX Spark GB10 지원을 추가한 포트다. 현재 상태를 하나의 baseline으로 두고 있다.
결론적으로 지금까지의 테스트에서는:
- Dense 모델: GB10에서는 llama.cpp + 경량 GGUF 구성이 여전히 매력적이다.
- Qwen3.6-35B-A3B 계열 MoE: NInfer GB10 포트가 실제로 검토할 만한 성능 차이를 보여줬다.
처음에는 단순히 “RTX 5090 전용에 가까운 CUDA 엔진을 GB10에서 돌릴 수 있을까?”라는 호기심으로 시작했다.
그런데 막상 끝까지 가보니 더 흥미로운 것은 포팅 자체가 아니었다.
같은 추론 엔진도 Dense와 MoE에서 결과가 완전히 달랐고, GB10의 대용량 메모리와 제한된 메모리 대역폭이라는 특성이 어떤 모델 구조와 잘 맞는지가 숫자로 드러났다.
그게 이번 포팅에서 얻은 가장 큰 결과였다.