생성형 AI는 왜 오목을 잘 두지 못할까? — 예상과 달랐던 실험 결과 - LLM Omok Experiment
2016년 알파고는 바둑을 정복했고, 2026년 생성형 AI는 아직 오목판 위에서 길을 잃는다
2016년 3월, 전 세계는 한 장면에 숨을 죽였다. 구글 딥마인드의 알파고(AlphaGo)가 이세돌 9단을 꺾은 그 순간, 인류는 "AI가 인간을 넘어섰다"는 충격과 경외를 동시에 느꼈다.
10년이 지난 2026년. 우리는 매일 AI를 손 안에서 사용한다. ChatGPT, Claude, Gemini는 글을 쓰고, 코드를 작성하고, 이미지를 생성한다. 누군가는 "이제 AI는 인간보다 똑똑하다"고 말한다.
솔직히 말하면, 나도 이 AI가 오목을 잘 둘 거라고는 기대하지 않았다. 생성형 AI와 알파고는 아키텍처부터 완전히 다르다는 걸 알고 있었으니까. 그런데 궁금했다. 도대체 얼마나 못 둘까? 그리고 그 한계를 LLM 레벨에서 어디까지 개선할 수 있을까?
답은 예상보다 훨씬 흥미로웠다. 초기의 생성형 AI는 오목을 단 한 판도 이기지 못했다. 위협을 발견하지 못했고, 보드 상태를 놓치는 일도 자주 발생했다. 하지만 실험은 거기서 끝나지 않았다.
이 실험은 "AI가 오목을 못 둔다"는 사실을 확인하는 것을 넘어, 왜 못 두는지, 그리고 그 한계를 어떻게 극복할 수 있는지를 단계적으로 추적한 기록이다.
실험 설계: LLM vs 룰 기반 봇
실험 구성은 단순하다. 15x15 표준 오목판에서 생성형 AI(LLM)와 룰 기반 봇(RuleBot)이 대결한다.
RuleBot은 200줄 남짓의 단순한 평가 함수다. 빈 칸마다 "내가 여기 두면 5목이 되는가? 상대 4목을 막을 수 있는가? 열린 3을 만들 수 있는가?"를 점수로 환산해 가장 높은 곳에 둔다. 전략적 사고는 없다. 그냥 숫자 계산이다.
LLM Player는 OpenAI 호환 API에 연결된 AI 플레이어다. 매 턴 보드 상태를 텍스트로 받아 "생각"한 후 수를 결정한다. 시스템 프롬프트에는 오목의 규칙, 좌표 체계, 위협 패턴의 예시까지 상세히 적어줬다.
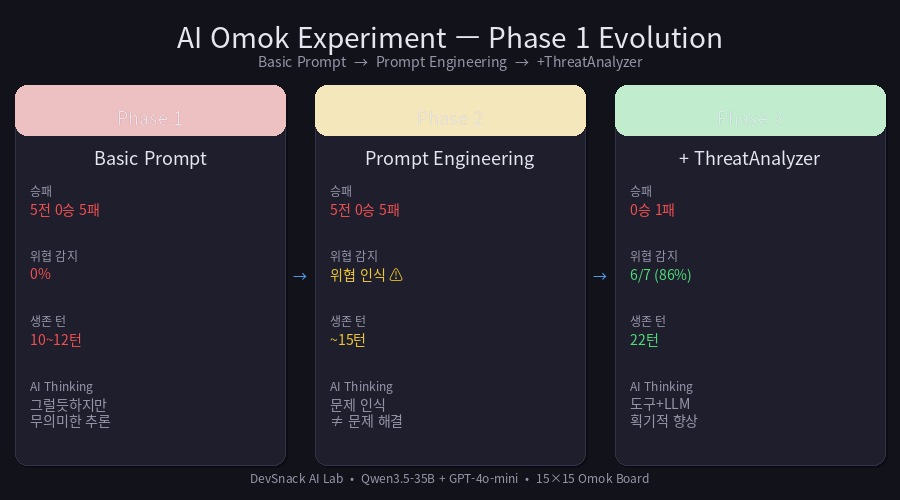
1단계: 기본 프롬프트 — 5전 전패, 위협 감지율 0%
첫 번째 실험. 기본 프롬프트만 주고 LLM에게 오목을 두게 했다. 결과는 예상보다도 훨씬 처참했다.
5전 전패. 평균 10~12턴. 위협 감지 0%.
가장 인상 깊었던 장면은 Turn 7이었다. AI는 H8-I9-J10으로 대각선 3개를 연결하며 공격적인 전략을 펼치고 있었다. AI의 사고 과정을 보면 "H8-I9-J10으로 대각선 3연결을 완성하고, 가로/세로로도 확장할 수 있는 좋은 위치"라고 분석하고 있었다.
그리고 다음 수. AI가 선택한 위치는 A1이었다. 15x15 보드에서 가장 먼 구석. 방금까지 대각선 공격을 말하던 AI가, 갑자기 보드 끝으로 이동한 것이다. 보드의 상태를 더 이상 추적하지 못한 것이다.
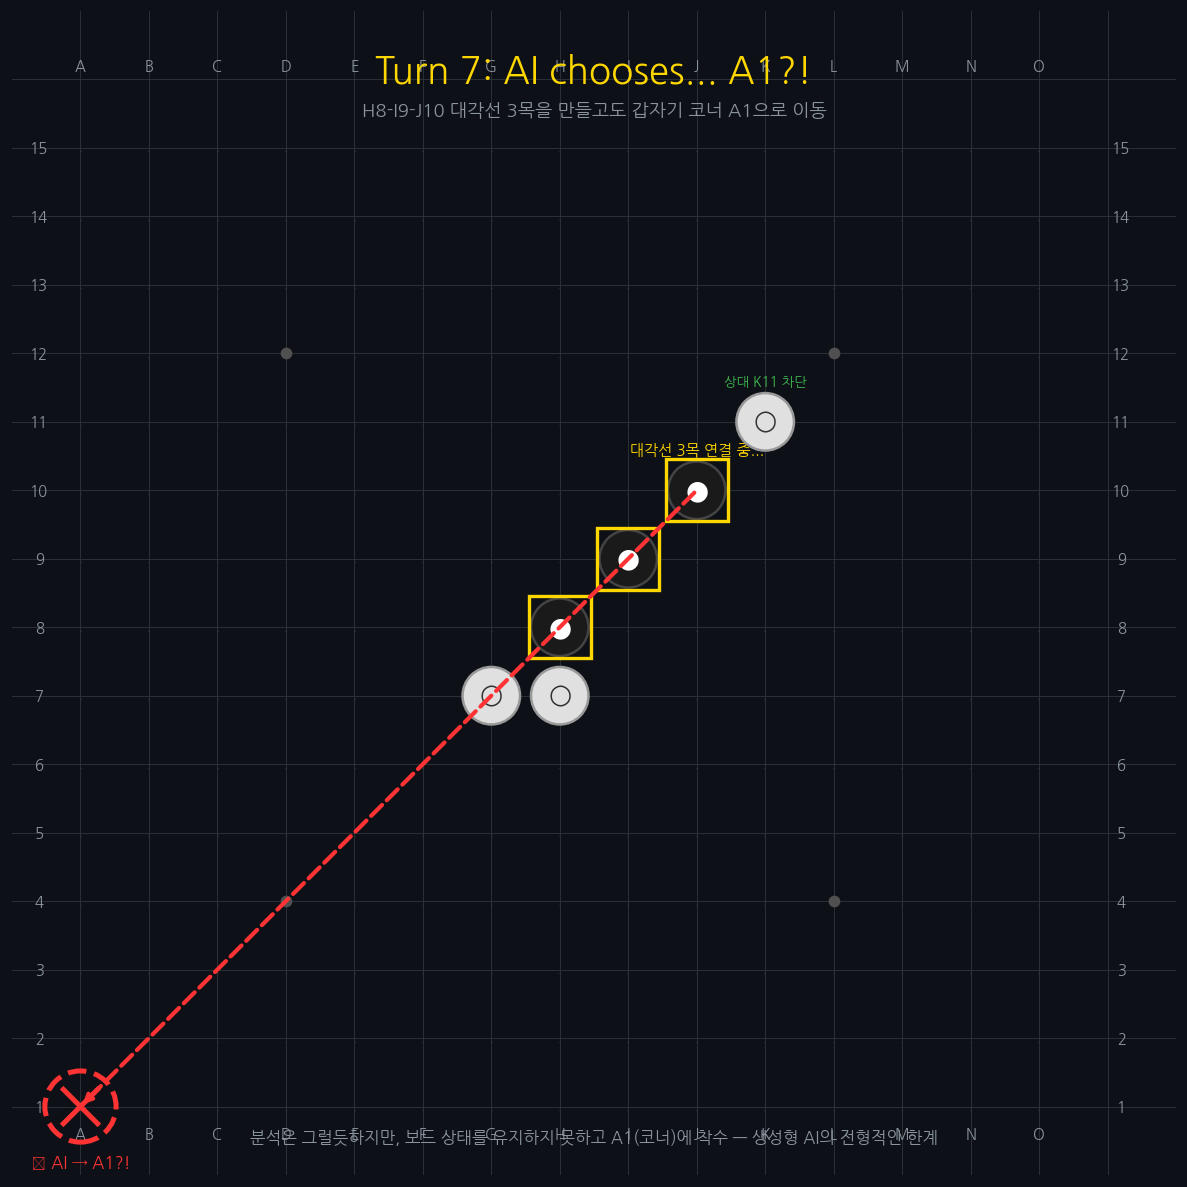
▲ H8-I9-J10 대각선 3개 연결 후, AI가 선택한 A1. 빨간색 점선이 AI의 선택, 금색 테두리가 방금까지 연결하던 대각선.
이것이 생성형 AI의 본질이다. 이 모델들은 오목을 "이해"한 것이 아니라, 오목을 설명하는 텍스트의 패턴을 학습한 것이다. 마치 시험 문제의 답을 외웠지만 원리는 모르는 학생처럼, AI는 그럴듯한 추론 과정을 생성할 수 있지만 장기적인 상태 추적과 수읽기 능력에는 분명한 한계가 있다.
2단계: 프롬프트 엔지니어링 — "더 길게 설명할 뿐"
여기서 끝내기엔 아쉬웠다. 과연 LLM 레벨에서 더 나아질 방법이 있을까?
시도 1: 컨텍스트 증가. 출력 토큰을 512에서 16384로 늘리고, 지금까지의 수순 히스토리를 매 턴 함께 전달했다. 결과는? 더 길고 그럴듯한 설명을 생성했지만, 수의 질은 거의 변하지 않았다. 단순히 더 많은 컨텍스트를 제공하는 것만으로는 장기적인 상태 추적 문제가 해결되지 않았다.
시도 2: 위협 패턴 교육. 시스템 프롬프트에 "열린 3(Open Three)", "열린 4(Open Four)", "3-3 더블 쓰리", "3-4 쓰리-포" 같은 개념을 상세한 예시와 함께 주입했다. 방어 우선순위도 가르쳤다.
결과: 드디어 AI가 위협을 "발견"하기 시작했다. Turn 9에서 처음으로 "상대가 열린 3을 형성하고 있습니다. 차단이 필요합니다"라는 문장이 출력됐다. 이전에는 전혀 나오지 않던 반응이었다.
그러나 여기에도 함정이 있었다. 발견과 실행 사이의 간극이다. AI는 위협의 존재를 인지했지만, 정확히 어디를 막아야 하는지는 계속 틀렸다. 문제를 인식하는 것과 문제를 해결하는 것은 생성형 AI에게 전혀 다른 능력이었다. 이 문장은 오목뿐 아니라 현재 생성형 AI 전체를 설명하는 통찰이기도 하다.
3단계: 도구의 연결 — ThreatAnalyzer
여기서 나는 방향을 바꿨다. LLM 혼자 하게 두지 말고, 도구(Tool)를 붙이자.
만든 것은 ThreatAnalyzer. 보드의 모든 라인(가로 15줄 + 세로 15줄 + 대각선 29줄)을 스캔해 3연결 이상의 위협을 구조화해서 프롬프트에 주입하는 컴포넌트다.
■ 상대 위협 (높은 위험순):
  ○ 백 4연결 (열림, 세로): E10, F9, G8, H7
  → 열린 끝: D11, I6
  ⚠️ 즉시 차단 필요: D11, I6
단순한 작업이다. 사람이라면 눈으로 보고 바로 알 수 있는 정보를, AI가 다시 추론하지 않도록 구조화해서 전달한 것뿐이다. 그런데 그 효과는 극적이었다.
ThreatAnalyzer 도입 이후 AI는 7개의 주요 위협 중 6개를 감지하고 차단했다. 22턴까지 버텼고, 이전에는 위협조차 발견하지 못했던 AI가 정확한 위치에 방어석을 두기 시작한 것이다.
흥미로운 점은, LLM 자체는 거의 바뀌지 않았다는 것이다. 바뀐 것은 모델이 아니라 주변 시스템이었다. AI가 혼자 하게 두지 않고, 외부 분석 도구를 붙여 정보를 구조화해서 전달했을 뿐이다.
물론 완벽하지는 않았다. Turn 19, 단 한 번의 위치 실수. 상대의 열린 3을 발견했지만, 차단 위치로 H6을 선택했다. 정답은 E6이었다. 이 한 번의 실수로 22턴 만에 패배했다. 그러나 그 전에는 단 한 번의 위협도 막지 못했던 AI가, 단 하나의 외부 도구만으로 6번 연속 정확히 차단해낸 것은 분명한 진보다.
이 실험이 말해주는 것
이 실험은 세 가지 중요한 사실을 드러낸다.
첫째, 생성형 AI는 보드를 계산하지 않고 텍스트를 독해한다. 알파고는 보드를 텐서로 처리하고 MCTS로 수천 수를 시뮬레이션한다. 방식이 완전히 다르다. 당연히 결과도 다르다.
둘째, 단순히 더 많은 컨텍스트를 제공하는 것만으로는 장기적인 상태 추적 문제가 해결되지 않았다. 이는 "GPT에게 블로그 글을 쓰게 했더니 중간에 주제를 잊어버리더라"는 수많은 사용자 경험과 정확히 일치한다.
셋째, 그러나 도구(Tool)가 이 한계를 획기적으로 보완할 수 있다. ThreatAnalyzer라는 단순한 함수 하나로 LLM의 오목 성능은 10턴에서 22턴으로, 위협 감지율은 0%에서 86%(7회 중 6회)로 향상됐다.
이번 실험은 LLM 기반 오목 에이전트 실험에 가까웠다. LLM + Tool + 외부 분석이 결합되면서 비로소 의미 있는 성능이 나오기 시작했다. 생성형 AI는 혼자서는 약하지만, 주변 시스템과 연결되면 훨씬 강력해진다. 이것이 현재 AI 시대를 이해하는 가장 중요한 포인트다.
생성형 AI는 오목을 잘 두는 AI가 아니다.
하지만 오목을 잘 두는 시스템의 일부가 될 수는 있다.
Phase 2 예고: AI가 만든 엔진은 강할까?
이 실험은 1단계에 불과하다. 다음 질문은 더 재미있다: "생성형 AI는 오목을 못 두더라도, 오목을 잘 두는 엔진을 만들 수 있을까?"
Phase 2에서는 AI에게 Python 기반 오목 엔진을 직접 설계하고 구현하게 시킬 예정이다. 실제 오픈소스 오목 엔진(Rapfi)과 NPC vs NPC 대결을 붙여볼 생각이다.
AI가 플레이어가 아니라 개발자가 된다면, 결과는 달라질까?
사용 모델: Qwen3.5-35B (llama.cpp, 로컬 추론) / GPT-4o-mini
전체 코드: GitHub (준비 중)
DevSnack AI Lab — AI를 소비하는 채널이 아니라, AI를 실험하는 연구실