생각보다 잘하는데, 생각보다 멍청했다
생각보다 잘하는데, 생각보다 멍청했다
--- Hermes Agent의 두뇌를 GPT로 바꾸고 알게 된 것
최근 내가 사용하고 있는 Hermes Agent의 오케스트레이터 모델을 바꿨다.
기존에는 OpenCode.ai의 Go 서비스를 통해 DeepSeek V4 Flash를 사용하고 있었는데, 이번에는 ChatGPT 쪽으로 옮겨 GPT-5.6 Luna를 연결했다.
바꾸고 나서 처음 며칠은 꽤 만족스러웠다.
빠르고, 코딩도 잘하고, 문제 해결 능력도 확실히 좋아진 것처럼 보였다. 이전에 느끼던 답답함이 한꺼번에 사라진 느낌도 있었다.
그런데 계속 이것저것 시켜보니 이상한 점이 하나씩 눈에 들어오기 시작했다.
생각보다 잘하는데, 생각보다 멍청했다.
정확히 말하면 능력이 부족한 것은 아니었다.
시키는 일은 정말 잘했다.
문제는 시키는 일만 정말 잘한다는 것이었다.
시작은 모든 것을 로컬에서 돌리는 것이었다
현재 나는 NVIDIA DGX Spark GB10에 Hermes Agent를 올려 사용하고 있다.
처음 구축할 때의 목표는 단순했다.
가능한 모든 것을 로컬에서 돌려보자.
그래서 Hermes의 주력 모델로 Qwen3.6 35B A3B를 사용했다.
이 정도 모델이면 생각보다 많은 일을 할 수 있다.
자료를 정리하고, 간단한 코드를 작성하고, 서버를 관리하고, 블로그 자동화 파이프라인을 만들고, 크론잡을 관리하고, 각종 로컬 도구를 연결하는 정도의 작업은 충분히 가능했다.
실제로 블로그 자동화, 주식 분석, 영상·음성 파이프라인, AI 실험 환경 등 꽤 많은 시스템을 이 방식으로 구축했다.
특히 자주 사용했던 방법은 상용 LLM과 로컬 LLM의 역할을 나누는 것이었다.
상용 LLM의 무료 또는 저비용 티어를 이용해 전체 구조를 설계하고 문제를 검토한다.
그리고 실제 파일 생성과 시스템 구축은 로컬 Qwen에게 맡긴다.
설계가 어느 정도 제대로 되어 있다면 로컬 모델도 여러 번의 수정과 테스트를 거쳐 결국 원하는 결과까지 만들어냈다.
개인 취미와 학습을 위한 시스템으로서는 꽤 만족스러웠다.
그런데 한 가지 문제가 있었다.
컴퓨터가 하나였다.
AI에게 일을 시키는데, 그 AI가 GPU를 쓰고 있다
▲ 오케스트레이터와 생성 작업이 한 대의 GPU를 공유하면 생기는 병목
DGX Spark는 128GB 통합 메모리를 가지고 있어 큰 모델을 로컬에서 돌리는 데 상당히 재미있는 장비다.
문제는 내가 Hermes에게 시키는 일 역시 대부분 AI와 관련되어 있다는 것이다.
예를 들어 이런 일을 시킨다.
새로운 LLM을 받아서 벤치마크해봐.
그런데 Hermes 자신도 로컬 LLM으로 돌아가고 있다.
오케스트레이터가 GPU 자원을 사용하면서 동시에 다른 모델을 로딩해 벤치마크해야 한다.
이미지 생성도 마찬가지다.
ComfyUI로 이 이미지를 만들어봐.
영상 생성도 마찬가지다.
LTX로 이 캐릭터를 움직여봐.
일을 지시하는 AI와 실제 작업을 수행하는 AI가 같은 하드웨어 자원을 놓고 경쟁한다.
가능은 하지만 불편하다.
특히 모델을 계속 내렸다 올렸다 해야 하는 작업에서는 자동화의 장점이 상당 부분 사라진다.
그렇다고 DGX Spark를 하나 더 사는 것도 애매했다.
최근 반도체 관련 이슈로 가격이 많이 오른 상황에서 개인 취미용으로 한 대를 더 구입하기에는 부담스럽다. 게다가 GB10의 메모리 대역폭 특성상 장비를 추가한다고 내가 원하는 모든 작업의 속도가 극적으로 빨라지는 것도 아니다.
말 그대로 가성비가 사라진다.
결국 다른 방법을 찾았다.
오케스트레이터만 클라우드로 보내자.
OpenCode Go와 DeepSeek V4 Flash
그때 선택한 것이 OpenCode.ai의 Go 서비스였다.
비교적 저렴한 비용으로 여러 모델을 사용할 수 있었고, 그중 DeepSeek V4 Flash가 내 용도와 상당히 잘 맞았다.
사용량도 넉넉했고 속도도 빨랐다.
물론 100% 만족스러운 것은 아니었다.
가끔 답답하게 행동했고, 한 번에 제대로 해결하지 못하는 문제도 있었다. 같은 설명을 반복해야 할 때도 있었다.
그래도 에이전트에게 일을 시키는 입장에서는 중요한 장점이 있었다.
계속 시키면 결국 해냈다.
첫 번째 방법이 실패하면 두 번째 방법을 찾고, 그것도 실패하면 다시 수정한다.
몇 번의 iteration을 허용하면 실제 사용할 수 있는 결과까지 도달했다.
무엇보다 로컬 GPU가 자유로워졌다.
Hermes는 외부 모델로 생각하고 명령을 내리고, DGX Spark에서는 LLM 벤치마크든 이미지 생성이든 영상 생성이든 필요한 작업을 자유롭게 돌릴 수 있었다.
두어 달 동안 꽤 만족하면서 사용했다.
그런데 8월 중순 무렵 OpenCode Go의 가격 및 사용량 정책이 바뀌면서 상황이 달라졌다.
이전까지는 사용량을 크게 신경 쓰지 않고 사용했는데, 어느 날 평소처럼 작업하고 확인해보니 하루 만에 주간 사용 한도의 약 85%가 소진되어 있었다.
이건 내가 원했던 용도와는 맞지 않았다.
오케스트레이터는 내가 사용량을 계산하면서 말을 아껴야 하는 존재가 아니라, 하루 종일 이것저것 던져놓을 수 있어야 했다.
그래서 다시 대체 모델을 찾기 시작했다.
Claude냐 GPT냐
후보는 자연스럽게 Claude와 GPT로 좁혀졌다.
둘 다 평소 내가 좋아하는 스타일의 모델이다.
순수한 결과물만 놓고 보면 작업에 따라 Claude가 더 마음에 들 때도 있고 GPT가 더 마음에 들 때도 있다.
하지만 이번에는 최고의 결과물 하나를 뽑는 것이 목적이 아니었다.
Hermes Agent의 오케스트레이터가 필요했다.
내 작업 방식도 고려해야 했다.
나는 처음부터 완성된 계획을 세우고 AI에게 명세서를 넘기는 스타일이 아니다.
AI와 이야기하다가 아이디어가 떠오른다.
그 아이디어를 조금 해본다.
결과를 보고 다른 생각이 난다.
그러면 방향을 바꾼다.
또 이야기한다.
그러다 보면 처음 생각했던 것과 전혀 다른 프로젝트가 만들어져 있기도 한다.
그래서 내게는 순간적인 최고 성능보다 오랫동안 부담 없이 대화를 이어갈 수 있는 것이 중요했다.
당시 확인한 사용 조건에서는 Claude 쪽의 주간 한도가 GPT보다 빡빡하다고 판단했다.
유튜브의 모델 비교를 보면 Sol이나 Fable 같은 상위 모델 사이에도 결과물에서 조금씩 차이가 난다. 하지만 내게 필요한 것은 최고 점수를 받는 모델이 아니었다.
Hermes의 오케스트레이터 역할이라면 GPT-5.6의 막내급인 Luna로도 충분하겠다는 생각이 들었다.
그래서 Luna를 선택했다.
와, 답답한 게 다 없어졌는데?
Hermes의 provider를 바꾸고 Luna로 실행하자 첫인상은 상당히 좋았다.
기존에 느꼈던 답답함이 많이 사라졌다.
문제를 이해하는 속도도 빨랐고 코드를 수정하는 것도 빨랐다.
여러 파일을 읽고 구조를 파악하거나, 기존 시스템에서 필요한 부분을 찾아 수정하는 능력도 확실히 좋아진 느낌이었다.
처음 며칠은 이런 생각까지 들었다.
이 정도면 굳이 더 높은 모델이 필요할까?
Hermes의 오케스트레이터 역할이라면 Luna 정도로도 충분해 보였다.
그런데 계속 이것저것 시켜보니 조금 이상했다.
그런데 왜 시키는 것만 하지?
최근 재미있는 실험 하나를 시작했다.
AI에게 2D 게임 에셋을 만들어보라고 했다.
GPT Image로 캐릭터를 만들고, 같은 캐릭터의 이동·공격·점프 등의 이미지를 만든다.
그 이미지를 LTX 같은 영상 생성 모델에 넣어 실제 움직임을 생성한다.
영상에서 배경을 제거하고 프레임을 분리해 게임용 sprite로 사용하는 실험이었다.
여기에 아이디어를 하나 더 추가했다.
영상으로 만들지 말고 GPT Image에게 아예 연속된 동작의 sprite sheet를 직접 만들게 해보자.
그러면 재미있는 비교가 가능하다.
한쪽은:
GPT Image → Sprite
다른 한쪽은:
GPT Image → LTX Video → Frame extraction → Sprite
같은 캐릭터를 두 방식으로 움직여보고 캐릭터 일관성, 움직임의 자연스러움, 프레임 연결, 제작 비용 등을 비교할 수 있다.
그런데 작업 과정을 보면서 이상한 점들이 보이기 시작했다.
최종 결과물은 192×192 정도의 게임 sprite인데 LTX 영상 workflow는 704×704를 그대로 사용하고 있었다.
물론 영상 모델의 제약 때문에 그 해상도가 필요할 수도 있다.
그렇다면 먼저 확인하면 된다.
그런데 그런 판단 과정이 없었다.
기존 workflow에 그 값이 있으니 그냥 사용한 것이다.
ComfyUI에서 이미지가 깨지는 문제가 발생했을 때도 비슷했다.
가장 먼저 입력과 출력 해상도, resize 과정, workflow의 dimension을 점검하기보다 기존 구조를 유지한 상태에서 다른 해결책을 찾으려 했다.
그리고 첫 Showcase에서는 더 단순한 문제가 생겼다.
원본 영상의 길이와 추출한 프레임 수를 제대로 연결하지 않은 채 프레임 수를 재생 fps처럼 사용했다.
그 결과 영상의 시간축이 압축됐고, 프레임이 많아질수록 모션이 더 빨라지는 것처럼 보였다.
문제를 지적한 뒤에는 빠르게 수정했다.
1:1 캔버스로 다시 맞추고, 2초 Walk는 48프레임, 3초 Walk는 72프레임으로 맞췄다. 원본 영상 시간과 데모의 재생 시간도 다시 연결했다.
고치는 능력은 충분했다.
문제는 처음부터 한 번만 더 생각했으면 필요 없었을 이터레이션이었다.
더 결정적인 것은 실험의 목적이었다.
이 실험의 목적은 예쁜 애니메이션을 보여주는 것이 아니다.
AI가 만든 결과물을 실제 게임 sprite로 사용할 수 있는지 확인하는 것이다.
그렇다면 데모 역시 게임 에셋이라는 조건을 중심으로 만들어져야 한다.
프레임 타이밍은 어떤가.
루프가 자연스러운가.
캐릭터의 중심점이 흔들리지는 않는가.
공격 동작에서 실제 타격 프레임은 어디인가.
그런데 작업은 내가 말한 산출물을 하나씩 만드는 방향으로 흘렀다.
그때 느낌이 왔다.
어? 얘 그냥 내가 시키는 대로만 하는데?
잘하는데, 이상하게 수동적이다
이상했다.
아무리 GPT-5.6 계열의 막내 모델이라지만 이 정도 판단을 못 할 것 같지는 않았다.
코딩 능력이 부족한 것도 아니었다.
오히려 각각의 작업은 상당히 잘했다.
문제는 전체 목적을 다시 생각해서 기존 지시나 workflow를 바꾸는 행동이 거의 없다는 것이었다.
말 그대로 성능 좋은 Instruction Mode처럼 느껴졌다.
시키면 잘한다.
정확히 시키면 더 잘한다.
그런데 내가 잘못된 방향으로 시키고 있어도 같이 그 방향으로 열심히 달린다.
그래서 모델을 바꾼 지 나흘 정도 된 시점에 Hermes 내부를 한번 점검해보기로 했다.
메모리와 위키, Skill, persona와 관련된 문서를 전부 다시 확인하게 했다.
그리고 원인을 어느 정도 찾았다.
범인은 AI가 아니라 내가 쌓아놓은 규칙이었다
역시 난장판이었다.
Hermes를 운영한 기간 동안 여러 모델을 사용했다.
Qwen도 사용했고 DeepSeek도 사용했고 지금은 GPT를 사용한다.
모델마다 문서를 정리하는 스타일도 달랐다.
무엇을 중요하다고 판단하는지도 달랐다.
그리고 나는 AI가 실수할 때마다 그것을 고치기 위한 규칙을 계속 추가했다.
AI가 기술적인 내용을 추측해서 틀리면:
기술적인 내용은 추측하지 마.
라는 규칙이 생긴다.
사용자가 거절한 해결책을 계속 제안하면:
사용자가 거절한 해결책은 다시 제안하지 마.
라는 규칙이 생긴다.
기존 위키에 해결 방법이 있는데 새로 삽질하면:
항상 위키를 먼저 읽어.
라는 규칙이 생긴다.
문제가 생길 때마다 해결책을 memory나 Skill에 추가했다.
당시에는 합리적인 행동이었다.
문제는 그것이 몇 달 동안 쌓였다는 것이다.
실패할 때마다 법을 하나씩 만들었다
이번에 확인한 working-with-this-user라는 Skill 문서는 놀라울 정도로
커져 있었다.
원래 목적은 단순했다.
"이 사용자와 어떻게 일해야 하는가."
그런데 시간이 지나면서 그 안에는 사용자와 일하는 방식뿐 아니라 과거에 있었던 실수의 전말, ComfyUI 문제 해결법, Supabase 운영 절차, Vercel 확인 방법, credential 관리, workspace 정리 방법, 블로그 운영 규칙 같은 것까지 들어가기 시작했다.
한마디로:
7월 3일에 이런 사고를 쳤으므로 앞으로 이것을 금한다.
를 두 달 동안 반복한 셈이다.
실패할 때마다 법을 하나씩 만들었다.
그리고 더 큰 문제가 있었다.
각각의 규칙은 혼자 보면 대부분 맞았다.
하지만 같이 놓으면 충돌하기 시작했다.
한쪽에는:
사용자의 입력을 임의로 바꾸지 마라.
라고 되어 있다.
다른 쪽에는:
기존 workflow를 현재 목적에 맞게 수정해라.
라고 되어 있다.
또 다른 곳에는:
기존 지식과 workflow를 먼저 찾아라.
라고 되어 있고,
다른 곳에는:
사용자의 의도를 우선하라.
라고 되어 있다.
사람에게는 문맥에 따라 적당히 판단할 수 있는 문장들이다.
AI에게는 그렇지 않을 수 있다.
AI는 규칙이 왜 생겼는지 모른다
여기서 꽤 재미있는 점을 발견했다.
사람은 항상 동일하게 행동하지 않는다.
오늘의 나는 어제의 나와 생각이 다를 수 있다.
지난달에는 안정성을 가장 중요하게 생각했는데 이번 달에는 속도가 더 중요할 수도 있다.
처음에는 AI에게:
절대 네 판단대로 바꾸지 마.
라고 화를 냈다가,
몇 달 뒤에는:
왜 네가 알아서 판단을 안 해?
라고 할 수도 있다.
사람끼리는 어느 정도 이해한다.
상황이 달라졌으니까.
그런데 에이전트에게는 두 문장 모두 사용자가 직접 만든 중요한 규칙이다.
AI 입장에서는 어느 쪽을 버려야 하는지 명확하지 않다.
특히 memory와 Skill과 wiki 여러 곳에 비슷한 규칙이 서로 다른 표현으로 저장되어 있다면 더 복잡해진다.
그리고 가장 안전한 행동을 선택한다.
시키는 것만 한다.
생각해보면 상당히 합리적이다.
괜히 기존 workflow를 바꿨다가 "왜 멋대로 바꿨어?"라는 규칙을 위반하는 것보다, 사용자가 말한 것을 정확히 실행하는 것이 안전하다.
내가 Luna에게서 느꼈던 이상한 수동성은 모델의 지능 문제만으로 설명할 일이 아니었다.
어쩌면 내가 몇 달 동안 만든 규칙이 Luna에게 "판단하지 않는 것이 안전하다"고 가르치고 있었던 셈이다.
문제는 모델 하나가 아니라 쌓인 하네스였다
특히 "위키·Skill·메모리를 먼저 확인하라"는 규칙은 원래 이미 알고 있는 지식을 활용하라는 뜻이었다.
같은 조사를 매번 처음부터 반복하지 말라는 의미였다.
그런데 시간이 지나면서 이 문장이 사실상:
기존 workflow가 있으면 그 값을 따라간다.
에 가까운 행동으로 굳어져 있었다.
워크플로는 활용해야 하는데, 워크플로 자체를 다시 판단하는 행동은 약해졌다.
문서에는 지식이 쌓였지만 실행에는 과거의 가정도 함께 쌓였다.
이건 단순히 Luna만의 문제도 아니었다.
오랜 기간 여러 모델이 같은 시스템에 흔적을 남기면서 만들어진 하네스 전체의 문제였다.
규칙을 추가하는 대신 규칙을 지웠다
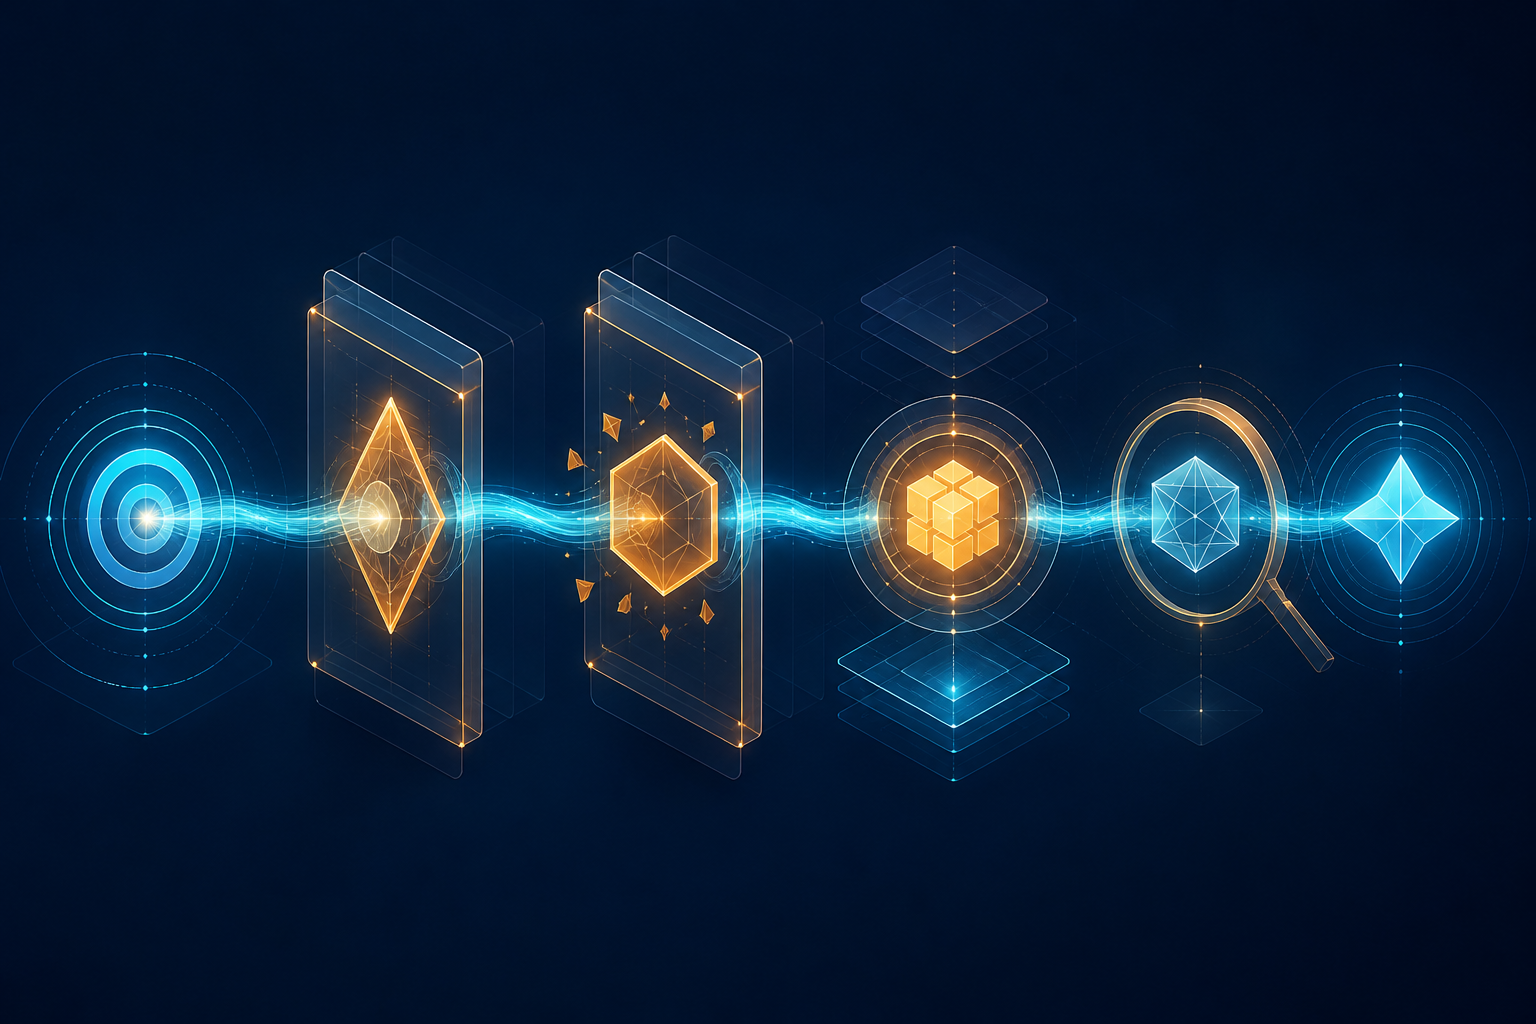
▲ Intent → Inspect → Challenge → Execute → Verify
그래서 이번에는 새로운 HARD RULE을 추가하지 않았다.
반대로 지우기 시작했다.
과거 사건의 상세 기록은 log나 reference로 분리했다.
ComfyUI나 Supabase 같은 특정 기술의 HOW-TO는 해당 기술 문서로 보냈다.
프로젝트별 운영 규칙도 각 프로젝트의 문서로 분리했다.
구체적인 context 충돌 검사는 별도의 preflight Skill로 분리했다.
그리고 working-with-this-user에는 정말 필요한 행동 원칙만 남겼다.
핵심 흐름은 꽤 단순해졌다.
Intent → Inspect → Challenge → Execute → Verify
먼저 사용자가 실제로 원하는 결과가 무엇인지 본다.
기존 지식과 workflow를 확인한다.
하지만 그것을 그대로 믿지 않는다.
현재 목적과 맞는지 다시 검토한다.
잘못된 가정이 있으면 바꾼다.
안전한 범위에서는 스스로 판단해서 실행한다.
그리고 명령이 성공했는지가 아니라 실제 결과가 목적을 달성했는지 확인한다.
특히 한 문장을 중심에 놓았다.
Instructions describe the goal and constraints, not necessarily the implementation.
사용자의 지시는 목표와 제약을 설명하는 것이지, 반드시 구현 방법 전체를 고정하는 것은 아니다.
물론 내가:
704 해상도로 그대로 만들어. 해상도는 바꾸지 마.
라고 명시했다면 그대로 해야 한다.
하지만 단순히 기존 workflow가 704라는 이유만으로 그 값을 사용하고 있다면:
최종 결과물이 192인데 왜 704가 필요한가?
정도는 스스로 생각해야 한다.
내가 원했던 것은 말을 잘 듣는 AI가 아니라 같이 문제를 해결하는 AI였기 때문이다.
Memory Debt
▲ 기억이 많아질수록 지식이 아니라 부채가 될 때가 있다
LLM의 context window는 계속 커지고 있다.
에이전트의 memory 시스템도 좋아지고 있다.
Vector DB도 있고, RAG도 있고, 장기 기억 시스템도 있다.
무엇이든 기억하게 만드는 것은 점점 쉬워지고 있다.
그런데 이번에는 오히려 반대쪽 문제가 보였다.
기억을 많이 하는 것이 항상 좋은 것은 아니다.
오래된 판단.
이미 해결된 문제.
특정 상황에서만 필요했던 규칙.
서로 다른 시기의 사용자 요구.
서로 다른 모델이 중요하다고 판단해 남긴 기록.
이것들이 계속 쌓이면 어느 순간 기억은 지식이 아니라 부채가 된다.
소프트웨어의 technical debt와 비슷하다.
나는 이것을 일종의 Memory Debt라고 생각하게 됐다.
코드를 리팩터링하듯 AI의 기억도 가끔 리팩터링해야 한다.
중복된 규칙을 합치고,
오래된 상태를 history로 보내고,
기술 절차와 사용자 성향을 분리하고,
현재의 나와 맞지 않는 규칙은 다시 판단해야 한다.
모델을 바꾸면 에이전트도 달라진다
이번 경험에서 또 하나 배운 것이 있다.
Hermes든 OpenCode든 Codex든 Claude Code든 에이전트 프레임워크만 유지하면 모델을 갈아끼워도 비슷하게 움직일 것이라고 생각하기 쉽다.
실제로는 그렇지 않았다.
같은 memory.
같은 Skill.
같은 wiki.
같은 tool.
같은 시스템.
그런데 모델이 바뀌면 행동이 달라진다.
어떤 모델은 애매한 지시에서도 적극적으로 추론한다.
어떤 모델은 기존 절차를 충실하게 따른다.
어떤 모델은 기록을 길게 남긴다.
어떤 모델은 위험을 피하기 위해 멈추고, 어떤 모델은 일단 실행한 뒤 고친다.
그래서 장기간 사용하는 AI Agent라면 모델만 업데이트해서 끝나는 것이 아니다.
새로운 모델이 기존 memory와 Skill을 어떻게 해석하는지도 다시 봐야 한다.
어쩌면 모델을 교체하는 것은 사람으로 치면 같은 회사의 후임자에게 이전 담당자의 업무 노트를 전부 넘겨주는 것과 비슷할지도 모른다.
문서는 같아도 읽는 사람이 다르면 행동은 달라진다.
결국 AI를 관리한다는 것
처음 Hermes를 만들 때는 좋은 모델과 많은 기억을 주면 점점 더 나를 잘 이해하는 AI가 될 것이라고 생각했다.
절반은 맞았다.
실제로 시간이 지날수록 내가 사용하는 환경도 많이 알고, 예전에 만든 시스템도 찾고, 반복 작업도 훨씬 잘한다.
하지만 다른 절반이 있었다.
나도 변한다.
내 작업 방식도 바뀌고,
사용하는 모델도 바뀌고,
중요하게 생각하는 것도 바뀌고,
처음에는 필요했던 규칙이 나중에는 방해가 되기도 한다.
그 변화를 AI가 자동으로 모두 이해할 것이라고 기대하면 안 된다.
사람은 어제의 자신과 오늘의 자신이 달라도 자연스럽게 받아들인다.
AI에게는 어제의 내가 남긴 문장도 오늘의 내가 남긴 문장도 똑같이 중요한 context일 수 있다.
그래서 장기적으로 AI Agent를 사용한다면 모델 관리만큼이나 기억과 규칙의 관리가 중요하다.
내가 변하면 AI도 같이 변할 수 있도록.
가끔은 새로운 것을 기억시키는 것보다,
무엇을 더 이상 지키지 않아도 되는지 알려주는 일이 더 중요하다.
그리고 이번 경험에서 마음에 남은 표현이 하나 있다.
AI의 성격은 모델 카드에만 적혀 있지 않다. 우리가 쌓아둔 과거의 문장들 사이에도 만들어지고 있다.
이번에는 AI에게 새로운 능력을 추가한 것이 아니다.
오히려 두 달 동안 쌓아놓은 규칙을 걷어냈다.
아직 Luna로 전환한 지 며칠밖에 되지 않았다.
그래서 이것을 GPT-5.6 Luna의 최종 평가라고 할 생각은 없다.
오히려 이제부터가 실험이다.
정리된 Skill과 memory를 가진 Luna가 기존 workflow를 얼마나 잘 재평가하는지, 사용자가 지적하기 전에 문제를 발견하는지, 불필요한 iteration이 줄어드는지를 조금 더 지켜볼 생각이다.
그리고 다시 2D 게임 sprite 실험으로 돌아간다.
이번에는 Luna가 704라는 숫자를 보고 한 번쯤 먼저 생각했으면 좋겠다.
"그런데 이거, 최종 출력이 192인데 왜 704로 만들고 있죠?"
그 질문을 먼저 하기 시작한다면,
이번 리팩터링은 성공한 것이다.